
你好。上一课我们用链式法则在简单计算图中手工完成了反向传播:前向阶段保存中间值,反向阶段把局部导数与上游梯度相乘;若同一变量经多条路径影响损失,则累加各路径的贡献。
但手算正确、代码也能运行,并不意味着训练中的梯度实现一定正确。尤其在实现自定义 loss、奖励函数或后训练目标时,一个符号、mask、归一化位置或 detach() 用错,都可能让训练“看起来在跑”,却沿着错误方向更新。本课学习一种独立的检查手段:有限差分梯度校验。它通过微小扰动输入或参数、重新计算标量损失,得到数值近似梯度,并与自动微分结果对照。
本课结束后,你应能为一个简单计算图手工和用 PyTorch 实现中心差分,并能解释校验失败时到底更可能是梯度逻辑、浮点精度、步长,还是不可导点造成的问题。
有限差分:用两次前向计算测量局部斜率
对于单变量标量函数:
导数的定义是当扰动无限趋近于零时的变化率。计算机不能真正取“无限小”,但可以取一个很小的有限步长 。
最直接的前向差分是:
实际做梯度校验时,更推荐中心差分:
它在 的两侧各测一次函数值,取中间的割线斜率。直觉上,两侧的误差会彼此抵消一部分。
用泰勒展开可以看出差异。前向差分的截断误差量级是:
中心差分的截断误差量级则是:
因此,在相同且合适的步长下,中心差分通常更准确。代价是每检查一个参数分量,需要额外进行两次前向计算。
先用 CS231n 的说明建立中心差分、相对误差和常见陷阱的整体框架。
CS231n Deep Learning for Computer Vision
阅读 Stanford CS231n 的 “Gradient Checks”。它将有限差分放在神经网络调试语境中,并强调:梯度校验不是只看两个数“差得小不小”,还必须考虑数值尺度、浮点精度和不可导点。
在 “Gradient Checks” 中,先阅读开头关于前向差分与中心差分的段落,尤其跟随 中心差分的理由,理解为何不应默认使用单侧公式。 接着阅读同一节中 “Use relative error for the comparison” 与 “Use double precision” 两部分。从举例说明绝对误差不可靠的段落开始,读到 相对误差和双精度建议。注意作者给出的阈值是诊断经验,不是跨所有网络和数值条件都成立的定律。 最后阅读小节 “Kinks in the objective” 和其后的 “Be careful with the step size h”。重点理解 跨越不可导点的情形:此时数值梯度与自动微分梯度不一致,不必然说明反向传播写错了。
从标量到计算图:一次只扰动一个自由变量
考虑上一课出现过的带分叉计算图:
取:
前向计算得到:
根据链式法则,自动微分或手工反向传播给出:
现在不使用导数公式,只用前向计算来估计 方向的梯度。令:
固定 ,分别将 增大和减小 。
当 时:
当 时:
于是中心差分给出:
同样,固定 ,只扰动 :
这里恰好得到精确值,是因为这个损失是关于 的二次或线性函数,中心差分对这类函数尤其准确。对于包含 sigmoid、exp、log 等非线性节点的图,结果通常只是非常接近,而非逐位完全相同。
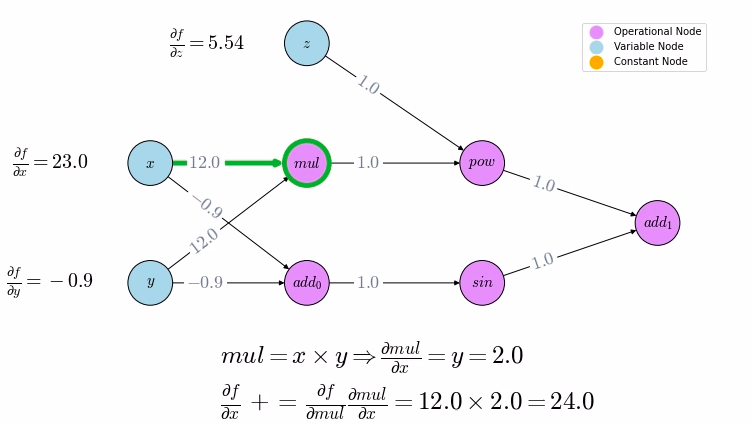
这说明有限差分和自动微分在做两件不同但应一致的事:
- 自动微分沿计算图应用链式法则,得到解析意义上的梯度;
- 有限差分不关心图内部怎样反传,只观察输入微调后最终标量输出怎样变化;
- 两者一致时,说明“已实现的前向函数”和“已实现的反向梯度”彼此匹配。
注意最后一句的范围:梯度校验验证的是代码实际定义的目标函数及其梯度是否一致;它不能证明你的奖励设计、数据标注或训练目标本身符合业务意图。
参数向量的梯度校验
训练时通常有很多参数。把所有待检查参数展平成一个向量:
损失为:
要估计第 个分量的数值梯度,只修改 ,其余所有参数保持不变。令 为第 个位置为 、其余位置为 的单位向量,则:
自动微分给出的对应值是:
完整梯度校验需要对每个 重复上述过程。这解释了为何它很昂贵:若参数有 个,数值梯度至少需要约 次前向计算,而反向传播只需一次前向和一次反向,便可同时获得所有参数的梯度。
因此,梯度校验的定位是:
- 实现新算子、自定义 loss、奖励模型损失或特殊 mask 后的单元测试;
- 在极小模型、极小 batch、少量随机参数位置上运行;
- 不在真实的大模型训练循环中每一步执行。
对于后训练尤其重要的一点是:应检查一个固定、确定性的标量目标。例如,用固定 token、固定 labels、固定 attention mask 的小 batch 检查损失函数。不要直接对包含采样 rollout、随机 dropout 或变化中的奖励服务的整条在线 RL 流程做普通有限差分,因为两次前向输出的变化可能来自随机性,而不是参数扰动。
下面的视频展示了把多个参数及其梯度展平后,逐分量进行双侧扰动和整体比较的标准流程。
观看 DeepLearningAI 的《Gradient Checking (C2W1L13)》。视频将“扰动一个标量”的思想推广到整组权重和偏置参数,并给出向量梯度的比较方法。
先看 逐分量扰动。重点确认每次只修改一个参数分量,其余参数必须完全保持不变。 随后看 向量比较。关注将数值梯度和反向传播梯度汇总成同形状向量后,为什么要用归一化误差而不是只看绝对差。
怎样比较数值梯度与自动微分梯度
仅看绝对误差:
并不可靠。假设误差是:
若两个梯度本身都接近 ,这个误差可能可以接受;若梯度量级是:
那么它已经比梯度本身还大,显然不合理。
对于单个参数分量,可以使用对称的相对误差:
若两者都为零,应直接视为该分量通过,而不是执行零除法。
对于一组梯度,也常用整体度量:
这个指标适合判断整体是否接近;但调试时还要查看每一个分量的误差。一个很大的错误可能被大量正确、接近零的梯度掩盖。
对于使用双精度、平滑函数、很小计算图的检查,可将如下经验作为起点:
| 相对误差量级 | 初步解释 |
|---|---|
| 小于 | 对简单平滑图通常非常可信 |
| 到 | 通常可接受,但应检查最差分量与数值设置 |
| 到 | 需要警惕;可能有实现错误、步长问题或不可导点 |
| 大于 | 简单平滑图中通常强烈暗示实现错误 |
这些阈值不是硬规则。深层网络误差会累积;含 ReLU、max、排序和条件分支的目标存在不可导点;低精度运算也会限制可达到的误差。因此,正确做法不是机械追求某一个数字,而是结合计算图结构诊断。
用 PyTorch 校验一个小型损失
继续使用上一课的单神经元例子:
其中:
上一课已经得到:
下面的代码让 PyTorch 自动微分计算该值,再通过中心差分独立近似同一个梯度。
import torch

torch.set_default_dtype(torch.float64)

x = torch.tensor(2.0)
b = torch.tensor(-1.0)
y = torch.tensor(1.0)

def loss_from_w(w):
    z = w * x + b
    a = torch.sigmoid(z)
    return 0.5 * (a - y).pow(2)

# 1. 自动微分梯度
w = torch.tensor(0.5, requires_grad=True)
loss = loss_from_w(w)
loss.backward()

grad_auto = w.grad.item()

# 2. 中心差分数值梯度
h = 1e-5
w_value = w.detach()

loss_plus = loss_from_w(w_value + h).item()
loss_minus = loss_from_w(w_value - h).item()

grad_num = (loss_plus - loss_minus) / (2 * h)

# 3. 相对误差
denominator = max(abs(grad_auto), abs(grad_num))
if denominator == 0.0:
    relative_error = 0.0
else:
    relative_error = abs(grad_auto - grad_num) / denominator

print(f"loss         = {loss.item():.10f}")
print(f"autograd     = {grad_auto:.10f}")
print(f"finite diff  = {grad_num:.10f}")
print(f"relative err = {relative_error:.3e}")
预期现象是:
autograd接近 ;finite diff也接近 ;- 相对误差很小。
这里有几个实现细节值得固定下来:
-
损失必须是标量。
有限差分估计的是一个标量函数对某个变量的变化率。若原始输出是逐 token loss,先明确用何种 reduction 得到最终 scalar loss。 -
扰动时不应构建不必要的计算图。
代码中用w.detach()取出当前数值,再构造 与 。数值梯度的两次前向不需要调用backward()。 -
使用
float64。
两个很接近的 loss 相减会发生消去误差。float32下,即使梯度逻辑正确,也可能得到看似很大的相对误差。 -
所有非待测因素必须固定。
固定数据、随机种子、mask、loss reduction 和模型状态。若模型包含 dropout,应使用eval()模式进行检查;否则 与 的差异混入了随机掩码变化。 -
数值梯度不参与参数更新。
它只是验证工具。真正训练仍依赖自动微分的梯度,因为有限差分在大参数模型上不可承受。
当检查失败时:按现象定位原因
梯度校验失败不应立刻得出“自动微分错了”的结论。按照以下顺序排查,通常效率更高。
1. 检查比较对象是不是同一个标量目标
这是最常见的概念错误。例如:
- 自动微分使用了 batch mean,数值前向却使用 batch sum;
- 自动微分只对 assistant token 计算损失,数值前向遗漏了 loss mask;
- 一边使用 temperature 或 KL 系数,另一边没有;
- 一边对 reward 做了归一化,另一边没有。
有限差分校验的核心前提是:两侧调用的是同一份前向目标函数,仅参数的一个分量不同。
2. 检查符号、缩放和梯度累加
若数值梯度约为自动微分梯度的相反数,优先检查是否把“最大化奖励”和“最小化负奖励”混淆。
若两者只差一个稳定倍数,优先检查:
- reduction 是
sum还是mean; - 是否除以有效 token 数;
- 梯度累积时是否重复除以累积步数;
- 多个 loss 项是否漏掉某一项系数。
若只有共享参数或残差相关的部分出错,则回到上一课的原则:同一变量经多条路径影响目标时,梯度贡献必须累加。
3. 检查步长 ,但不要盲目越小越好
步长太大时,局部线性近似不够好,截断误差变大。步长太小时, 和 在浮点数中几乎无法区分,相减后反而放大舍入误差。
对一个小型、平滑、双精度的测试,可以尝试:
如果不同 下数值梯度大致稳定,并接近自动微分梯度,结果更可信。若 改变一点就剧烈波动,优先怀疑数值精度或非平滑结构。
4. 检查是否跨越了不可导点
ReLU 的定义为:
在:
处没有唯一的普通导数。自动微分框架会采用某种约定;而有限差分会同时访问 与 ,可能跨过零点,得到与该约定不同的斜率。
类似风险也存在于:
max、argmax;- 硬阈值和条件分支;
- 排序、截断;
- 采样得到的离散 token;
- 含有离散选择的奖励规则。
解决方式不是强行让两个数字一致,而是把测试点移离边界、减少 batch 规模以降低跨越 kink 的概率,或为平滑的可微子模块单独写梯度校验。
将它用于后训练代码的最小流程
当你将来修改一个自定义偏好损失、奖励模型 pairwise loss,或 Agent 轨迹中的某个可微辅助目标时,可以采用以下小型流程:
- 构造一个固定的极小输入,例如一两个样本、很短序列和确定的 mask。
- 让目标函数只返回一个标量 loss。
- 使用双精度,并关闭 dropout 等随机因素。
- 先检查少数几个随机选中的参数分量,或只检查自定义模块的输入张量。
- 打印每个被检分量的自动微分值、数值值和相对误差。
- 若失败,先确认前向目标完全一致,再检查符号、归一化、mask、
detach()和不可导分支。 - 检查通过后,再切回正常精度、正常 batch 和正式训练配置。
这套流程的价值不在于替代端到端训练评测,而在于把“训练效果不好”这种模糊问题,提前缩小为“某个局部计算图的梯度是否正确”这一可验证问题。
小结
有限差分为自动微分提供了一条独立的验证路径:
- 对单变量,优先使用中心差分:
- 对参数向量,每次只扰动一个分量,其余参数与输入保持不变:
- 用相对误差而非单纯绝对误差比较数值梯度与自动微分梯度。
- 梯度校验应在小型、确定性、双精度的测试中使用;它不适合大模型完整训练循环。
- 误差偏大时,优先检查目标是否一致、符号和缩放、步长与精度、以及是否跨越 ReLU 等不可导点。
至此,计算图、反向传播和梯度校验构成了后续理解训练目标的最小微积分工具箱。下一课将转向概率基础:从离散联合分布计算边缘概率、条件概率,并使用贝叶斯公式更新概率判断。
Can't find a good explanation? Sign up and we'll make it for you
Sign up