
你好。上一课我们完成了有限差分梯度校验:通过对某个参数施加微小扰动、比较两次前向的标量损失,独立验证自动微分的梯度是否正确。那一课解决的是“模型如何沿着损失函数的局部斜率更新”。
从这一课开始,我们转向后训练同样离不开的另一种语言:概率。无论是理解模型对 token 的条件概率、评估器的误判率、偏好数据的噪声,还是分析奖励模型分数与真实质量的关系,核心问题往往都是:观察到一些证据后,应该如何更新原先的判断?
本节将从离散联合分布出发,计算边缘概率与条件概率,并推导和应用贝叶斯公式。你将尤其需要分清两种容易混淆、但含义截然不同的量:
以及:
联合分布:同时记录两个离散事件
设我们从一批 Agent 轨迹中随机抽取一条,并由人工审计其最终任务是否真正完成。定义两个随机变量:
- :轨迹是否真实正确;
- :自动评测器是否给出通过判断。
假设审计了 条轨迹,得到如下频数表:
| 真实结果 | 评测通过 | 评测未通过 | 合计 |
|---|---|---|---|
| 正确 | 54 | 6 | 60 |
| 不正确 | 8 | 32 | 40 |
| 合计 | 62 | 38 | 100 |
表格内部的每一个格子都描述两个事件同时发生的情况,因此它们对应联合概率。例如:
它的含义是:随机抽到一条轨迹时,这条轨迹既真实正确,又被评测器判为通过的概率为 。
类似地:
这 条是自动评测器误判为通过的轨迹。注意,联合分布中的所有格子加总必须为 :
形式化地,两个离散随机变量 的联合概率质量函数写作:
这里的逗号表示“同时满足”,不是先后顺序。
先用下面的材料建立“联合分布表中的单元格、边缘行列”这一基本视觉直觉。
17 Distributions of Two Discrete Random Variables – STAT 414
阅读 Penn State STAT 414 的这两节。它以两个骰子的结果为例,说明联合概率质量函数如何用二维表表示,以及如何从联合表中消去一个变量得到边缘分布。
在 Section 17.1 “Two Discrete Random Variables” 中,先跟随双色四面骰的例子,理解每个表格单元格都对应一个具体的二元结果。随后阅读关于 marginal probability mass functions 的段落,从 “Now, if you take a look back at the representation of our joint PMF in tabular form” 开始,到该段落结束。重点看作者如何通过对另一个变量的所有取值求和,得到 边缘分布的定义。
边缘概率:暂时忽略另一个变量
若我们只关心“随机轨迹真实正确的概率”,而不关心评测器给了什么判断,就需要把 的两种可能都纳入:
代入表中的数值:
这就是 的边缘概率。在表中,它对应“正确”这一行的合计。
同理,评测器通过的边缘概率是:
它对应“评测通过”这一列的合计。
一般地,若已知联合分布 ,则:
可以把“边缘化”理解为:保留你关心的变量,将另一个变量所有可能情况加总掉。
在后训练中,这种操作很常见。例如,若你记录“任务类型”和“是否成功”的联合统计,想知道总体成功率时,就需要对所有任务类型求和;想知道某一种任务的占比时,就需要对成功与失败求和。
边缘分布也必须是有效的概率分布:
对于本例:
条件概率:把总体缩小为一个子总体
现在问题变为:
已知一条轨迹被自动评测器判为通过,它真实正确的概率是多少?
这不是总体正确率 ,而是:
竖线 读作“在……条件下”或“已知……”。条件 的作用是改变统计总体:我们不再从全部 条轨迹中随机抽取,而只从 条“评测通过”的轨迹中抽取。
在这 条通过轨迹中, 条真实正确。因此:
也就是说,评测器给出“通过”时,该轨迹真实正确的概率约为 。
条件概率的一般定义是:
其中要求:
分子始终是“目标事件和条件事件同时成立”的概率;分母永远是竖线右侧条件事件的边缘概率。
这条规则可以防止最常见的错误:把分母写成目标事件的概率。
条件的方向会改变分母
继续使用同一张表,考虑另一句话:
已知轨迹真实正确,它被评测器判为通过的概率是多少?
这是:
此时总体变成 条真实正确轨迹,其中 条被判为通过:
所以:
而:
它们使用同一个联合概率 ,但分母不同、问题不同,通常数值也不同。
| 问题 | 条件总体 | 计算 | 结果 |
|---|---|---|---|
| 正确轨迹被判通过的概率 | 真实正确的 条 | ||
| 判通过的轨迹真实正确的概率 | 判通过的 条 | 约 |
一个实用判断方法是:先圈定竖线右边的群体,再在这个群体里数竖线左边事件发生了多少次。
下面的视频用频数表快速复习联合、条件概率以及贝叶斯公式的关系。
Probability Formulas, Symbols & Notations - Marginal, Joint, & Conditional Probabilities
观看 The Organic Chemistry Tutor 的 “Probability Formulas, Symbols & Notations - Marginal, Joint, & Conditional Probabilities”。它用统一的符号把“两个事件同时发生”“给定条件后的子总体”与贝叶斯公式连起来。
先看 联合概率,确认为什么联合事件可以写成条件概率与边缘概率的乘积。随后跳到 条件与贝叶斯,重点比较条件概率公式和贝叶斯公式中看似不同、实际相等的分子。
乘法公式与独立性:联合概率的两种分解
由条件概率定义移项可得:
同一个联合概率也可以从另一个方向分解:
放回轨迹例子:
这说明“真实正确”与“评测通过”之间存在统计联系。
若两个事件独立,知道其中一个发生并不会改变对另一个的概率判断。例如,若 与 独立,则应有:
但本例中:
而:
两者不相等,因此二者不独立。评测器的输出显然携带了关于真实正确性的额外信息,只是它并不完美。
这里的“相关”不等同于因果。联合分布、条件概率和贝叶斯公式讨论的是在数据中如何更新不确定性;仅凭这些数值,不能断言评测器的判断“造成”了回答正确。
贝叶斯公式:用证据更新判断
贝叶斯公式就是把同一个联合概率的两种分解方式相等:
解出 ,得到:
其中:
- 是先验概率:看到证据 前,对 的原始判断;
- 是似然:如果 为真,观察到证据 的概率;
- 是证据概率:总体上观察到 的概率;
- 是后验概率:看到证据 后更新得到的判断。
回到轨迹审计例子,令:
- :轨迹真实正确;
- :评测器判通过。
则:
这和前面直接从表中计算 的结果完全一致。贝叶斯公式并没有产生新信息;它只是让你能够利用更容易获得的条件概率、先验概率,恢复反方向的条件概率。
分母从哪里来:全概率公式
二元情形中,事件 的发生只可能来自 或 两种互斥情况,因此:
对轨迹例子:
这也解释了为什么贝叶斯公式的分母很关键:它衡量的是“证据在整个总体中出现得有多常见”。
基率:为什么高准确率不一定意味着高后验概率
医学检测是理解贝叶斯公式的经典场景,也直接对应后训练中的评测器、奖励模型或规则验证器问题:即使某个判断器在已知正例时准确率很高,也不意味着它给出的正面判断一定可靠。正例本身有多常见同样重要。
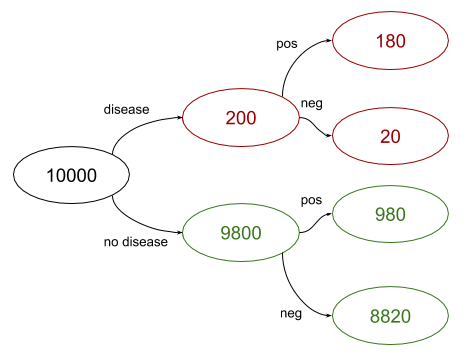
从图中读取:
其中 表示患病。检测的灵敏度为:
未患病者检测为阳性的概率,即假阳性率,为:
现在真正关心的是:
即“检测阳性的人实际上患病的概率”。
从人数直接计算:
也就是说,虽然检测对患病者的阳性率高达 ,检测阳性后真正患病的概率却只有约 。
用贝叶斯公式复算:
直觉上的关键在于:患病者本来极少。即使检测器有不错的灵敏度,规模更大的未患病人群仍会贡献许多假阳性。
这与后训练中的一个实际判断完全同构。假设一个自动评测器很擅长识别“真正高质量回答”,但你的候选池中真正高质量回答比例极低;那么,被评测器选中的回答中仍可能混入大量低质量样本。仅报告评测器在标注集上的“正类识别率”并不足以判断筛选结果是否可靠,还要看候选池的质量基率、误判率以及筛选后的后验精度。
从二维表到贝叶斯更新:一套稳定的解题流程
面对离散联合分布题,或分析一个小型评测统计表时,可以按下面的顺序处理:
-
定义事件与变量。
先明确每个事件的含义,例如 是真实正确, 是评测通过。 -
从表中找到联合概率。
同时发生的两个事件对应一个内部单元格,例如 。 -
根据问题计算边缘概率。
若问题只保留一个变量,就对另一个变量的全部取值求和。 -
确定条件概率的分母。
在 中,分母是 ,即竖线右边条件事件的总概率。 -
若已知的是反方向条件概率,则使用贝叶斯公式。
例如已知 、 和 ,但要计算 。 -
做三个检查。
联合表的所有单元格应加和为 ;每个条件分布应加和为 ;最终概率必须在 与 之间。
尤其要警惕下面这个常见错误:
它通常不成立。前者从“已观察到 ”的人群中问 的比例;后者从“已知 ”的人群中问 的比例。它们可能共享同一个联合事件,但观察总体不同。
小结
本节建立了从联合分布到贝叶斯更新的一条完整链路:
- 联合概率描述两个事件同时发生:
- 边缘概率通过对另一个变量的所有取值求和得到:
- 条件概率是在一个子总体中重新归一化:
- 联合概率可从任一方向分解:
- 贝叶斯公式使用证据更新先验判断:
对后训练而言,最值得形成习惯的一点是:看到评测器通过率、奖励模型高分率或筛选命中率时,主动追问其条件方向,以及候选集合中的基率。一个看似很高的条件概率,并不自动意味着反方向的质量保证。
下一课将继续处理离散分布,不过重点会从“事件之间如何关联”转向“一个随机变量的平均水平和波动程度”:期望、方差与协方差。
Can't find a good explanation? Sign up and we'll make it for you
Sign up