
你好。上一课我们从向量点积和矩阵乘法出发,理解了线性层的前向计算:输入特征与权重相乘、求和,再加上 bias。今天转向训练真正依赖的另一个问题:如果某个输入或参数轻微变化,输出会变化多少?
这正是导数与偏导数描述的内容。后训练中的损失函数、奖励模型分数、logits、概率和 KL 惩罚最终都会变成标量;反向传播则是在计算这些标量对大量参数的偏导数。本课先建立手算层面的直觉与基本规则。下一课会把它们组织成计算图中的链式法则。
导数:局部的变化率
对单变量函数
导数 描述的是:在 附近,输入 增加一点时,输出 大约以多快的速度变化。
在某个特定点 ,导数的严格定义是:
其中:
- 是对输入施加的一个很小的扰动;
- 分子是输出变化量;
- 二者的比值是平均变化率;
- 当 无限接近于 时,平均变化率趋于该点的瞬时变化率,也就是切线斜率。
训练中更实用的是这个近似:
它说明导数是函数在局部的一阶线性近似系数。若 ,输入在该点附近增加 ,输出大约增加 ;若导数为负,输出则会下降。
例如:
在 附近,导数是:
因此:
这并不意味着把 从 增加到 时输出恰好增加 ;实际增加量是:
导数说的是足够小的局部变化。例如令 :
而导数的一阶估计为:
误差 来自于 这样的高阶小量。
下面的片段用“正方形边长轻微增加时,面积增加多少”来解释为什么 的导数是 ,并进一步给出幂法则的直觉。
Derivative formulas through geometry | Chapter 3, Essence of calculus
观看 3Blue1Brown 的《Derivative formulas through geometry》。它把导数重新放回“微小扰动造成的输出变化”这一核心直觉中,并直观推导幂法则。
先看 问题与直觉,理解为什么我们需要从函数公式直接得到变化率。接着看 平方函数:重点关注面积增量中与 dx 成正比的两条窄条,以及为什么更高阶的小量在极限中消失。最后跳至 幂法则,把 x^2 的结论推广到 x^n。
一组必须熟练的标量导数
在后续推导中,不应每次都从极限定义重新计算。最常用的是下面几条规则。
常数、线性函数与幂函数
设 为常数, 为实数。在函数有定义的范围内:
最后一条称为幂法则。计算时可记为:“指数乘到前面,原指数减一。”
| 函数 | 导数 |
|---|---|
例如:
利用每一项分别求导:
注意常数 的导数是 。它会改变函数整体的数值,却不会改变函数随 变化的速率。
导数的线性性质
对函数 、 和常数 ,有:
因此,遇到多项式或加减组合时,可以拆项求导。这也是为什么前面的多项式例子可以逐项处理。
如果两个随 变化的函数相乘,则必须使用乘积法则:
例如:
这里 和 都随 变化,不能把导数误写为 。正确结果是:
在神经网络推导里,乘积法则经常以“某个局部项既作为一个值出现,又影响另一个值”的形式出现;下一课的计算图会系统处理它。
指数与对数:softmax 和对数概率的基础
后训练中频繁出现 exp、log_softmax、对数概率和 KL 散度,因此以下规则尤其重要:
指数函数的特殊之处是:函数值与其变化率相同。若 较大, 本身大,导数也大;若 很小,导数也小。这也是 softmax 直接计算指数时容易发生数值溢出的原因之一,后面学习数值稳定 softmax 时会重新用到这一点。
对数函数的导数:
揭示了一个重要特征:当 接近 的正侧时,导数会非常大。对数概率、概率比率或归一化分母接近零时,数值稳定性就会变得敏感。
对于机器学习中常见、但暂时不要求你自行推导的函数,可以先识别其导数形式:
以及:
这些结果依赖于今天的基本规则和下一课的链式法则。当前的目标是先知道:导数不是神秘的新函数,而是原函数在局部对输入变化的响应。
ReLU 的一个例外
ReLU 定义为:
因此,在非零位置:
在 处,左右两侧斜率不同,严格来说导数不存在。训练框架通常会在该点选择一个约定的次梯度,常见实现取 。这提醒我们:自动微分并不要求每个算子在每一点都拥有传统意义上的光滑导数,但模型设计通常会尽量避免这种不确定点造成严重问题。
从普通导数到偏导数
单变量函数只有一个输入方向,因此问“输入改变一点,输出怎样变化”是明确的。
但训练中的标量通常有许多输入。例如,单个线性单元:
这里 是输入, 是权重, 是 bias。它们都能影响 ,但影响方式不同。因此我们必须明确:究竟让哪个变量改变,其他变量保持不变?
这就是偏导数。
表示只改变 ,固定 ,观察 的变化率。
表示只改变 ,固定 。
表示只改变 ,固定 。
对上面的线性单元:
有:
这三个结果值得停下来理解:
- :输入变化对输出的影响由权重缩放;
- :权重的梯度会带有输入激活值;
- :bias 增加多少,线性输出就增加多少。
真实模型当然包含向量、矩阵和上亿参数,但反向传播底层就是在重复组合这类局部偏导数。
偏导数的计算规则:其他变量先当常数
设:
求关于 的偏导数时, 被视为一个常数:
逐项计算:
这里:
- 中的 像常数系数一样保留;
- 的偏导数是 ;
- 中没有 ,因此对 的偏导数为 。
求关于 的偏导数时,改为把 固定:
于是:
在点 处:
这两个值都等于 ,但含义不同:
- 固定 ,只沿 方向微调时,函数局部变化率为 ;
- 固定 ,只沿 方向微调时,函数局部变化率也为 。
数值偶然相同,并不代表两种扰动相同;在大多数函数和大多数点上,它们会不同。
下面的视频专门处理“多变量函数如何沿指定方向微小移动”这一问题。它包含在具体点求偏导和先得到一般公式两种做法。
Partial derivatives, introduction
观看 Khan Academy 的《Partial derivatives, introduction》。它将普通导数中的“微小推动”扩展到多变量函数,并清楚演示“固定其他变量”的计算规则。
从 方向的区别 开始,注意沿 x 与沿 y 的扰动是两个不同问题。接着观看 点上的偏导,观察讲解者如何先固定非目标变量,再代入具体点。继续看 一般公式,重点掌握“保留符号但把它当常数”的方法;最后用 核心总结 检查自己的表述是否准确。
偏导数的几何含义:固定一个方向,切出一条曲线
若
那么它的图像是一个三维曲面。普通导数的图像是曲线上的切线斜率;偏导数则是先沿某个坐标方向把曲面切开,得到一条曲线,再看该曲线上的切线斜率。
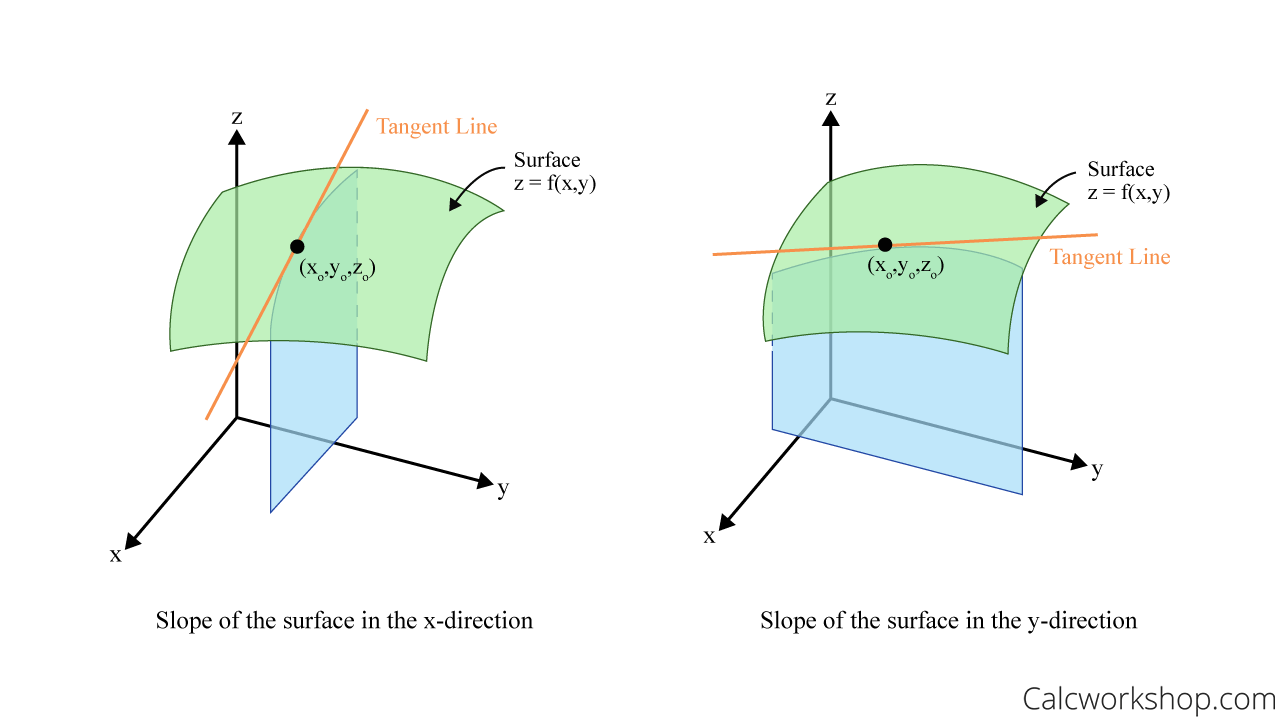
因此:
不是“整个曲面的唯一斜率”,而是固定 时,沿 方向的局部斜率。
同理:
固定 ,只考察 方向的局部斜率。
在神经网络训练中,损失 依赖大量参数:
某个参数的偏导数
表达的是:保持其他参数不动,只轻微调整 ,损失会如何局部变化。优化器最终正是依据这些偏导数决定每个参数的更新方向和更新幅度。
容易出错的地方
1. 混淆导数函数与某点的导数值
是一个关于 的新函数;而:
才是一个具体的标量值。
偏导数也一样:
是一般公式;只有代入点以后才得到特定数值。
2. 忘记“非目标变量是常数”
对于:
有:
而不是 。因为相对于 , 是一个常数系数。
同时:
而:
因为当我们只沿 方向移动时, 根本没有改变。
3. 把函数值当作导数值
不是 。在 时,函数值是 ,导数值是 。前者表示当前位置的输出,后者表示该点附近的变化率。
4. 忽略函数定义域
只在 的实数范围内成立。类似地, 在 无定义,ReLU 在 不可导。推导训练目标时,概率、归一化项和对数的定义域不能被忽略。
小结
本课建立了反向传播所需的第一层语言:
- 导数表示单变量函数在局部对输入微小变化的响应,也可看作切线斜率。
- 常用规则包括常数法则、幂法则、线性性质、乘积法则,以及 、 的导数。
- 偏导数用于多变量标量函数:对一个变量求导时,其他变量固定不动。
- 对线性单元 ,有:
这正是参数梯度为何与输入激活相关的最小原型。
下一课将学习链式法则:当一个损失经过多层运算得到时,如何把这些局部导数逐层组合,得到最终的参数梯度。
Can't find a good explanation? Sign up and we'll make it for you
Sign up