
你好。上一课我们建立了“形状语言”:线性层将输入的最后一维从 变为 ,而矩阵乘法要求相邻的中间维匹配。今天把这些规则落实到具体算术上:向量点积与小型矩阵乘法。
它们并不是脱离后训练的基础题。Transformer 的线性投影、注意力分数、奖励模型头,以及后续反向传播中的大量计算,底层都由“对应元素相乘并求和”组成。学完后,你应能手工算出一个线性层输出的来源,并在阅读 x @ W.T、Q @ K.transpose(-1, -2) 这类代码时知道每个数在做什么。
点积:把两组对应特征汇总成一个分数
设两个同长度向量为:
它们的点积定义为:
点积的输入是两个向量,输出却是一个标量,也就是一个单独的数。计算时必须满足两个向量长度相同;否则无法一一对应地相乘。
先看一个三维例子:
逐项相乘:
然后把结果求和:
这里最容易混淆的是:逐元素相乘和点积不是同一个操作。
| 操作 | 计算结果 | 输出形状 |
|---|---|---|
| 逐元素相乘 | 向量,长度为 3 | |
| 点积 | 标量 |
在 PyTorch 中,这一区别也非常直接:
import torch

a = torch.tensor([2.0, -1.0, 3.0])
b = torch.tensor([4.0, 5.0, -2.0])

elementwise = a * b       # tensor([ 8., -5., -6.])
dot = torch.dot(a, b)     # tensor(-3.)
a * b 只做逐元素乘法;torch.dot(a, b) 才会把乘积加总为一个数。对一维向量,a @ b 也会得到同一个点积结果。
下面这段 Khan Academy 视频用两个二维、三维例子说明“对应项相乘再相加”,并强调结果为什么是标量。
Vector dot product and vector length | Vectors and spaces | Linear Algebra | Khan Academy
观看 Khan Academy 的《Vector dot product and vector length》。它用最直接的方式建立点积的计算规则,适合先把“向量得到一个数”的操作感固定下来。
先看 点积定义,关注两个向量必须按相同位置配对、结果是标量这两点;接着看 手算例子,留意负数项和零项如何参与最终求和。
点积在模型里意味着什么?
把向量看成“特征的有序列表”时,点积可理解为:用另一组数对各个特征加权,再把贡献汇总成一个分数。
例如,某个 token 的隐藏表示是:
某个输出单元对应的权重是:
则该输出单元在加上 bias 前的值为:
其中每个权重决定对应输入特征对输出的贡献方式:
- 权重为正,会保留同号输入的正向贡献;
- 权重为负,会反转该输入特征的贡献方向;
- 权重为零,该特征不影响这个输出;
- 最终不是看某一维,而是看所有维度的加权和。
实际大模型中,隐藏维度可能是 、 或更高。手工当然不会逐维计算,但计算结构没有变化:一个输出特征就是输入隐藏向量与一行权重的点积,再加上 bias。
从一个点积到整张矩阵:每个输出位置都是“行点列”
矩阵乘法只是把点积系统地重复很多次。
设:
则矩阵积 存在,且:
其中 的列数 必须等于 的行数 。上一课称它为“中间维”;在手算中,它对应每个点积里需要相乘并累加的项数。
输出矩阵中第 行、第 列的元素为:
不用急着记住下标。更实用的语言是:
结果的第 个元素,等于左矩阵第 行与右矩阵第 列的点积。
这张图准确展示了这一规则:左侧矩阵 的每一行,与右侧矩阵 的每一列分别配对;每次配对产生结果矩阵 的一个元素。
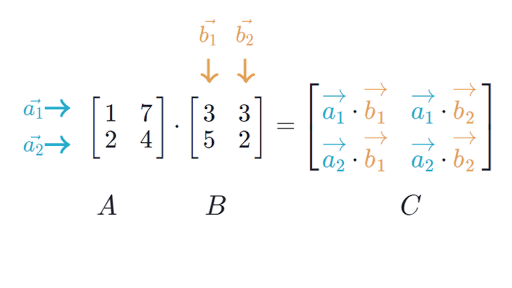
在开始算数字前,先做形状检查。图中的两个矩阵是:
它们都是 矩阵。中间维都是 ,因此乘法合法,输出也会是 :
现在按“行点列”逐格计算。
第一行、第一列
取 的第一行与 的第一列:
所以:
第一行、第二列
所以:
第二行、第一列
所以:
第二行、第二列
所以最终结果为:
手算矩阵乘法时,不要把“同位置元素相乘”误当成矩阵乘法。下面这个计算:
是逐元素乘法,不是矩阵乘法。它的形状恰好也是 ,因此只看 shape 无法分辨;必须看操作符和数学含义。
下面的视频完整演示了“先检查中间维,再逐格做行点列”的过程。
Multiplying a matrix by a matrix | Matrices | Precalculus | Khan Academy
观看 Khan Academy 的《Multiplying a matrix by a matrix》。它把一个矩阵积拆成四个点积,正好对应手算时应执行的动作。
先看 形状条件,确认为什么左矩阵列数必须等于右矩阵行数。然后从 逐格计算 看完:重点不是记住视频中的数字,而是追踪每个结果元素如何取左边的一行和右边的一列。
矩阵乘法的顺序不能随意交换
普通数满足:
但矩阵一般不满足:
对刚才的两个矩阵,反过来计算 :
它与之前的结果不同:
这不是偶然,而是矩阵乘法的基本性质。因为 中,左边矩阵提供“行”,右边矩阵提供“列”;交换顺序以后,参与每个点积的数和组合方式都变了。
放到模型代码中,顺序尤其关键。例如,设输入 batch 为 ,权重为 。若每行代表一个样本或 token 表示,常见计算是:
而不是任意交换成:
两者即使在形状碰巧允许时,也代表不同的计算。
线性层就是一组并行的点积
回忆上一课:PyTorch 中
layer = nn.Linear(in_features=H, out_features=O)
权重保存为:
若输入向量为:
线性层输出为:
这里的 有 行,每一行都表示一个输出特征对应的一套权重。于是:
- 的第一行与 做点积,得到 的第一个分量;
- 的第二行与 做点积,得到第二个分量;
- 重复 次,就得到 维输出。
看一个输入维度为 3、输出维度为 2 的小例子:
因为 存储为 ,实际矩阵乘法使用其转置:
于是:
第一个输出元素来自 与 第一行的点积:
第二个输出元素来自 与 第二行的点积:
因此,加 bias 后:
对应 PyTorch 验证代码如下:
import torch

x = torch.tensor([1.0, 2.0, -1.0])

W = torch.tensor([
    [2.0, -1.0, 0.0],
    [1.0, 3.0, 4.0],
])

b = torch.tensor([0.5, -1.0])

y = x @ W.T + b
print(y)  # tensor([0.5000, 2.0000])
对于语言模型中的 [B, T, H] 隐藏状态,这个逻辑逐 token 重复发生。线性层并不把 batch 中不同样本混在一起,也不会把不同位置的 token 自动相加;它对每个位置上的 维向量独立地做同一套点积计算,最终得到 [B, T, O]。
手算与读代码时的检查清单
今后遇到一个小型矩阵计算,或者试图理解某个投影层时,可以固定按以下顺序处理:
-
先写形状。
若 是 , 是 ,则 合法,结果为 。 -
确认中间维。
点积中有多少个对应项,就应有多少个相乘项。 乘 时,每个输出元素都恰好累加 项。 -
定位输出元素。
结果的第 个元素,固定取左侧第 行、右侧第 列。 -
分开处理乘法与求和。
先写每一对元素的乘积,再相加。包含负数时尤其不要跳步。 -
最后检查输出 shape 与语义。
输出行数来自左矩阵,输出列数来自右矩阵。若是线性层,还要确认是否需要加 bias。
常见错误包括:
- 将逐元素
*当作矩阵乘法@; - 只检查两个矩阵“大小差不多”,却没检查左列数和右行数;
- 计算某个输出位置时取了错误的行或列;
- 忘记转置 PyTorch 的
nn.Linear.weight; - 得到数值结果后,没有检查其 shape 是否仍符合预期。
小结
这一课的核心可以浓缩为两句话:
- 点积:对应元素相乘,再求和;输入是等长向量,输出是标量。
- 矩阵乘法:结果中每个元素都是“左矩阵一行”与“右矩阵一列”的点积。
进一步地,线性层的每一个输出特征,本质上都是输入特征与一行权重的点积,加上一个 bias。理解这一点,后面学习注意力中的 、语言模型 logits,以及梯度计算时,就不会只把它们看成黑箱张量操作。
下一课将转向导数与偏导数:从“如何算出一个输出”进一步走到“参数变化一点点,输出会变化多少”。
Can't find a good explanation? Sign up and we'll make it for you
Sign up