
Добрый день. В прошлом уроке вы восстановили функции: несколько возвращаемых значений, callback-функции и разделение логики по небольшим ответственностям. Теперь функциям нужны реальные наборы данных. В backend-разработке это будут списки задач, результаты SQL-запросов, наборы идентификаторов, настройки и кэши данных по ключу.
Сегодня вы разберёте три базовых контейнера Go и научитесь выбирать подходящий:
- массив — последовательность строго известного размера;
- срез (
slice) — последовательность переменной длины; - map — соответствие ключей значениям.
Главная цель — не просто запомнить синтаксис, а уметь объяснить, почему в конкретном коде нужен именно этот тип.
Модель выбора: порядок, размер или ключ
Все три типа хранят несколько значений, но отвечают на разные вопросы.
| Если нужно… | Обычно выбирайте | Пример |
|---|---|---|
| Хранить ровно фиксированное число элементов | Массив | Три уровня приоритета, 32 байта хеша |
| Хранить упорядоченный список, который может расти или сокращаться | Срез | Задачи проекта, полученные из БД |
| Находить значение по уникальному ключу | map | Пользователь по userID, счётчик статусов |
| Хранить только уникальные значения | map[T]struct{} | Набор ID участников проекта |
В прикладном Go-коде чаще всего встречаются срезы и map. Массивы важны не потому, что вы будете постоянно их создавать, а потому, что срезы опираются на массивы внутри. Также массив подходит, когда размер является частью контракта программы.
Массивы: размер входит в тип
Массив записывается как [N]T, где N — число элементов, а T — их тип:
var retryDelays [3]int

retryDelays[0] = 1
retryDelays[1] = 3
retryDelays[2] = 5

fmt.Println(retryDelays) // [1 3 5]
Индекс начинается с нуля. Для массива из трёх элементов допустимы только индексы 0, 1 и 2.
Размер массива — не просто свойство значения, а часть его типа:
var short [2]string
var long [3]string

// short = long // compilation error: [2]string and [3]string are different types
Можно объявить массив литералом:
priorities := [3]string{"low", "medium", "high"}
Или разрешить компилятору посчитать элементы:
priorities := [...]string{"low", "medium", "high"}
В обоих случаях типом будет [3]string.
Массивы копируются целиком
Массив — значение. Присваивание создаёт независимую копию всех элементов:
original := [3]string{"todo", "in_progress", "done"}
copyOfOriginal := original

copyOfOriginal[0] = "backlog"

fmt.Println(original)       // [todo in_progress done]
fmt.Println(copyOfOriginal) // [backlog in_progress done]
Это иногда полезно: например, при работе с небольшой неизменяемой таблицей фиксированного размера. Но для передаваемых между слоями приложения коллекций задач массив обычно слишком негибок: количество задач заранее неизвестно. Поэтому API и прикладной код почти всегда принимают []T, а не [N]T.
Go Slices: usage and internals
Прочитайте материал Go Slices: usage and internals из официального Go Blog, Andrew Gerrand. Он связывает три идеи, которые легко спутать на старте: массив как значение, срез как описание части массива и рост среза через append.
В разделе Arrays прочитайте основу про массивы: обратите внимание, что длина входит в тип и присваивание копирует массив. Затем в разделе Slices найдите абзац, который начинается словами тип среза, и дочитайте раздел до подраздела Slice internals. Зафиксируйте синтаксис []T, создание через литерал и make, а также полуоткрытые границы в выражении s[low:high]. В подразделе Slice internals изучите представление среза. После него прочитайте фрагмент от изменения через общий массив: он объясняет, почему два среза могут неожиданно видеть изменения друг друга. В разделе Growing slices (the copy and append functions) прочитайте от рост среза до примеров со встроенным append. Главный практический вывод: результат append нужно присваивать обратно.
Срезы: рабочая коллекция backend-кода
Срез имеет тип []T, без фиксированной длины:
taskTitles := []string{
	"Design API",
	"Write tests",
	"Deploy demo",
}
У среза есть:
- длина — число элементов, доступных сейчас через
len; - ёмкость — сколько элементов может поместиться в текущем базовом массиве до необходимости выделить новый, через
cap.
tasks := make([]string, 0, 5)

fmt.Println(len(tasks)) // 0
fmt.Println(cap(tasks)) // 5
Здесь tasks пока пуст, но программа заранее зарезервировала место для пяти строк. Это бывает уместно, если размер примерно известен: например, вы собираете список результатов из входного набора. Однако не стоит добавлять make(..., 0, N) везде без причины: обычный литерал или var часто лучше читается.
Slice header: почему срез — не массив
Концептуально срез содержит небольшой заголовок из трёх частей:
- указатель на первый доступный элемент базового массива;
- длину;
- ёмкость.
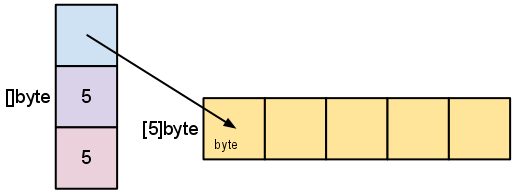
Поэтому присваивание среза не копирует все его элементы. Копируется заголовок, и обе переменные первоначально смотрят на общие данные:
allTasks := []string{
	"Design API",
	"Write tests",
	"Deploy demo",
}

todayTasks := allTasks[:2]
todayTasks[1] = "Write table-driven tests"

fmt.Println(allTasks)
// [Design API Write table-driven tests Deploy demo]
Выражение allTasks[:2] создаёт срез с элементами по индексам 0 и 1. Правая граница не включается. В общем виде в s[low:high] доступны элементы с индексами от low включительно до high исключительно.
Это удобно и эффективно, но требует дисциплины: если вы передаёте срез в функцию и меняете items[i], вызывающий код обычно увидит это изменение.
func markFirstTask(tasks []string) {
	if len(tasks) == 0 {
		return
	}

	tasks[0] = "[urgent] " + tasks[0]
}
Функция получает копию заголовка среза, но элементы остаются общими с исходным срезом.
Добавление элементов через append
Чтобы добавить элемент в конец среза, используйте append:
tasks := []string{"Design API", "Write tests"}

tasks = append(tasks, "Deploy demo")
tasks = append(tasks, "Prepare README")

fmt.Println(tasks)
// [Design API Write tests Deploy demo Prepare README]
Обязательное правило: сохраняйте результат append.
tasks = append(tasks, "Deploy demo")
Когда свободной ёмкости недостаточно, Go выделяет новый, более крупный базовый массив, копирует туда старые элементы и возвращает новый заголовок среза. Если не присвоить его обратно, переменная останется со старым заголовком и новая длина будет потеряна.
Чтобы добавить содержимое одного среза в другой, используйте ...:
baseTasks := []string{"Design API"}
extraTasks := []string{"Write tests", "Deploy demo"}

baseTasks = append(baseTasks, extraTasks...)
Когда нужно именно копирование
Если полученный фрагмент должен жить независимо от большого исходного списка, создайте новый срез и скопируйте данные:
allTasks := []string{
	"Design API",
	"Write tests",
	"Deploy demo",
	"Prepare README",
}

selected := allTasks[:2]

independent := make([]string, len(selected))
copy(independent, selected)

independent[0] = "Different task"

fmt.Println(allTasks[0])    // Design API
fmt.Println(independent[0]) // Different task
copy копирует минимум из длины источника и назначения и возвращает число скопированных элементов. В данном примере independent имеет собственный базовый массив, поэтому изменение не затрагивает allTasks.
Нулевое значение среза
Нулевое значение среза — nil:
var taskIDs []int64

fmt.Println(taskIDs == nil) // true
fmt.Println(len(taskIDs))   // 0

taskIDs = append(taskIDs, 42)
taskIDs = append(taskIDs, 99)
Для nil-среза безопасны len, cap, range и append. Это позволяет накапливать результаты без лишней инициализации:
func activeTaskTitles(tasks []string) []string {
	var active []string

	for _, task := range tasks {
		if task != "done" {
			active = append(active, task)
		}
	}

	return active
}
Позже, при работе с JSON API, станет важным различие между nil и пустым, но не-nil срезом. Пока достаточно помнить: для обхода и добавления элементов оба варианта работают корректно.
map: доступ к данным по ключу
map связывает ключ со значением. Например, ID пользователя можно связать с именем:
owners := map[int64]string{
	42: "Anna",
	77: "Mikhail",
}
Тип записывается как map[KeyType]ValueType:
map[int64]string
map[string]int
map[string]bool
В отличие от среза, у map нет числовых индексов и гарантированного порядка. Ключом может быть сравнимый тип: например, string, int, int64, указатель, массив или подходящая структура. Срез, map и функция ключами быть не могут.
scores := make(map[string]int)

scores["anna"] = 10
scores["mikhail"] = 15
scores["anna"] = 20 // обновляет прежнее значение

fmt.Println(scores["anna"]) // 20
На практике map стоит выбирать, если вопрос звучит так: «как быстро найти данные по конкретному ключу?» Например:
- имя пользователя по
userID; - настройка по имени;
- число задач по статусу;
- набор разрешённых ID;
- временный кэш результатов вычисления.
Изучаем Go. Урок №18. Мапы (maps) #golang
Посмотрите фрагменты видео «Изучаем Go. Урок №18. Мапы (maps) #golang» от ThisIsIT. Видео закрепит синтаксис создания map, чтения, записи и проверку наличия ключа — последняя особенно важна в обработчиках и прикладной логике.
Начните с создания map: обратите внимание на разницу между var, make и литералом, а также на то, почему make и литерал подходят для записи. Далее посмотрите запись и обновление, затем проверку ключа. Зафиксируйте двухзначное получение value, ok := m[key]: оно отличает отсутствующий ключ от реально сохранённого нулевого значения. Завершите удалением и обходом map. Не рассчитывайте на порядок результатов range.
Инициализация и nil map
Как и срез, map имеет нулевое значение nil:
var taskCount map[string]int

fmt.Println(taskCount == nil) // true
fmt.Println(taskCount["done"]) // 0
Чтение из nil map безопасно и возвращает нулевое значение типа элемента. Но записывать в неё нельзя:
var taskCount map[string]int

// taskCount["done"]++
// panic: assignment to entry in nil map
Для записи и обновления используйте make или литерал:
taskCount := make(map[string]int)

taskCount["todo"]++
taskCount["in_progress"]++
taskCount["in_progress"]++

fmt.Println(taskCount["in_progress"]) // 2
Здесь taskCount["todo"] до первого увеличения логически равно 0, поэтому ++ сразу создаёт запись со значением 1. Это делает map[string]int естественным инструментом для подсчёта.
Можно заранее передать make ожидаемый размер:
taskCount := make(map[string]int, 4)
Число 4 — лишь подсказка для начального выделения памяти. Это не ограничение: в map можно добавить и пятую, и сотую запись. В отличие от среза, у map нет cap.
Проверяйте наличие ключа
Если ключ отсутствует, обращение к map вернёт нулевое значение типа элемента:
owners := map[int64]string{
	42: "Anna",
}

fmt.Println(owners[77]) // пустая строка
Но пустая строка может быть и реальным сохранённым значением. Поэтому используйте двухзначную форму доступа:
ownerName, ok := owners[77]
if !ok {
	fmt.Println("Owner not found")
	return
}

fmt.Println(ownerName)
Это продолжает тему прошлого урока: выражение возвращает несколько связанных значений. Первое — данные, второе — признак их наличия.
Удаление и обход
Удаление выполняется встроенной функцией delete:
owners := map[int64]string{
	42: "Anna",
	77: "Mikhail",
}

delete(owners, 77)
delete(owners, 999) // безопасно, даже если ключа нет
Для обхода используйте range:
for id, name := range owners {
	fmt.Printf("Owner %d: %s\n", id, name)
}
Однако порядок обхода map не гарантирован. Нельзя использовать его для выдачи API, где нужен стабильный порядок задач, либо для тестов, сравнивающих строки вывода. Если порядок важен, обычно данные переносят в срез и сортируют; сортировку вы примените позднее при реализации REST-выдачи задач.
Собираем типы в небольшую программу
В следующем примере каждый контейнер выражает свою роль:
[3]stringхранит фиксированный набор обязательных этапов;[]stringхранит список задач, который может расти;map[string]intсчитает задачи по статусам.
package main

import "fmt"

func countStatuses(statuses []string) map[string]int {
	counts := make(map[string]int, len(statuses))

	for _, status := range statuses {
		counts[status]++
	}

	return counts
}

func main() {
	requiredStages := [3]string{
		"design",
		"implementation",
		"review",
	}

	taskTitles := []string{
		"Design API",
		"Write unit tests",
		"Prepare README",
	}

	// Берём первые две задачи. Это новый заголовок среза,
	// но элементы пока общие с taskTitles.
	todayTasks := taskTitles[:2]
	todayTasks[1] = "Write table-driven tests"

	// Список задач может расти.
	taskTitles = append(taskTitles, "Deploy demo")

	statuses := []string{
		"in_progress",
		"done",
		"in_progress",
		"todo",
	}

	statusCounts := countStatuses(statuses)

	fmt.Println("Required stages:", requiredStages)
	fmt.Println("All tasks:", taskTitles)
	fmt.Println("Tasks for today:", todayTasks)

	if doneCount, ok := statusCounts["done"]; ok {
		fmt.Println("Done tasks:", doneCount)
	}

	fmt.Println("In progress:", statusCounts["in_progress"])
}
Запустите программу из корня модуля:
go fmt ./...
go test ./...
go run .
Обратите внимание на два решения в коде:
requiredStages— массив, потому что здесь зафиксирован контракт из трёх этапов.taskTitles— срез, потому что число задач меняется.statusCounts—map, потому что статус выступает ключом, а количество — значением.
В реальном сервисе задача вскоре станет структурой с полями ID, Title, Status и AssigneeID. Но выбор контейнера останется тем же: обычно вы получите []Task, а для частого поиска построите map[int64]Task или map[int64]*Task, исходя из нужной семантики.
Типичные ошибки, которые полезно узнавать на ревью
Ожидать, что срез копирует элементы при присваивании.
a := []int{1, 2, 3}
b := a
b[0] = 99

fmt.Println(a) // [99 2 3]
Если нужна независимая коллекция, используйте copy.
Забыть присвоить результат append.
tasks := []string{"Design API"}

append(tasks, "Write tests") // результат проигнорирован
fmt.Println(tasks)           // [Design API]
Правильно:
tasks = append(tasks, "Write tests")
Писать в неинициализированную map.
var counts map[string]int

// counts["todo"] = 1 // panic
Правильно:
counts := make(map[string]int)
counts["todo"] = 1
Считать нулевое значение доказательством отсутствия ключа.
priority, ok := map[string]int{
	"normal": 0,
}["normal"]

fmt.Println(priority, ok) // 0 true
Значение 0 само по себе ничего не говорит о наличии ключа; этот факт даёт только ok.
Полагаться на порядок range по map.
for status := range statusCounts {
	fmt.Println(status)
}
Порядок может отличаться между запусками. Для упорядоченной выдачи используйте срез.
Итоги
Теперь у вас есть практическая схема выбора базовых коллекций Go:
- массив
[N]Tимеет фиксированный размер, причём размер входит в тип; присваивание копирует элементы; - срез
[]Tподходит для упорядоченных данных переменной длины; его заголовок ссылается на базовый массив; - срезы могут разделять элементы после присваивания или срезания, поэтому копирование нужно делать явно через
copy; appendможет вернуть новый срез, поэтому его результат всегда нужно сохранять;mapmap[K]Vхранит значения по ключу, требует инициализации перед записью и не гарантирует порядок обхода;value, ok := m[key]отличает отсутствующий ключ от нулевого значения;map[T]struct{}выражает множество уникальных значений.
В следующем уроке вы перейдёте от простых строк и чисел к структурам, методам и указателям. Это позволит описывать задачу как полноценную доменную сущность, а не как набор несвязанных значений.
Can't find a good explanation? Sign up and we'll make it for you
Sign up