
Здравствуйте. В прошлом уроке вы восстановили интерфейсы, неявную реализацию и композицию через embedding. В частности, вы уже видели, что error в Go — тоже интерфейс: тип удовлетворяет ему, если имеет метод Error() string.
Теперь перейдём к тому, как backend-код сообщает о нештатных ситуациях и при этом не теряет причины сбоя. Ошибки в Go — не исключения, которые «выбрасываются» автоматически, а обычные значения, которые функция возвращает вызывающему коду. Вместе с этим разберём defer: он позволяет зарегистрировать очистку ресурса сразу после успешного получения этого ресурса, не забывая о ранних return.
К концу урока вы сможете:
- создавать простые и структурированные ошибки;
- добавлять к ошибке контекст с сохранением первопричины;
- выбирать между
errors.Isиerrors.As; - понимать, когда оборачивать ошибку нельзя из-за границ абстракции;
- применять
deferдля файлов и других ресурсов, учитывая порядок выполнения и ошибкиClose.
Ошибка — это возвращаемое значение и часть контракта функции
В Go функция, которая может не выполнить свою задачу, обычно возвращает error последним результатом:
func FindTask(id int64) (*Task, error) {
	// ...
}
Успешный вызов возвращает полезный результат и nil:
task, err := FindTask(101)
if err != nil {
	// обработка ошибки
	return
}

fmt.Println(task.Title)
Если err != nil, результат рядом с ним обычно нельзя использовать, если документация функции явно не говорит об обратном. Проверять ошибку стоит сразу, пока понятно, какой именно вызов завершился неуспешно.
Базовый контракт error очень мал:
type error interface {
	Error() string
}
Метод Error() нужен прежде всего человеку: для логов, диагностики и сообщения разработчику. Но программе нельзя принимать решения по тексту ошибки. Например, такой код хрупок:
if err.Error() == "task not found" {
	// так делать не стоит
}
Текст может измениться из-за уточнения формулировки, добавленного контекста или локализации. Вместо строк применяют специальные значения и типы ошибок.
The secret to making Golang error handling a breeze
Посмотрите фрагменты видео The secret to making Golang error handling a breeze от Earthly. Оно быстро восстанавливает базовую модель ошибок Go, затем показывает два разных способа сообщить вызывающему коду, что именно произошло.
Начните с основ ошибок: error является интерфейсом, а функция возвращает ошибку как обычный результат. Затем посмотрите sentinel и типы, чтобы различить постоянное значение ошибки и структуру с дополнительными данными. После короткого пропуска перейдите к оборачиванию: сосредоточьтесь на том, как %w одновременно добавляет контекст для человека и сохраняет исходную причину для программы.
Sentinel errors: известные условия без разбора строк
Sentinel error — экспортируемая или внутренне известная переменная с фиксированным смыслом. Она подходит, когда вызывающему коду нужно различать конкретное состояние, но не нужны дополнительные данные.
var ErrTaskNotFound = errors.New("task not found")
Репозиторий или прикладной сценарий может вернуть её:
func FindTask(id int64) (*Task, error) {
	task, exists := tasks[id]
	if !exists {
		return nil, ErrTaskNotFound
	}

	return task, nil
}
Создать ошибку с постоянным текстом помогает errors.New. Имена sentinel errors обычно начинаются с Err, а текст пишется со строчной буквы и без точки.
Вызывающий код не сравнивает текст, а проверяет смысл условия:
task, err := FindTask(101)
if err != nil {
	if errors.Is(err, ErrTaskNotFound) {
		fmt.Println("задача не существует")
		return
	}

	return
}

fmt.Println(task.Title)
Почему именно errors.Is, а не err == ErrTaskNotFound? Прямое сравнение работает лишь пока ошибка не обёрнута. В реальном сервисе между источником ошибки и HTTP-обработчиком обычно несколько слоёв кода, и каждый должен иметь возможность добавить полезный контекст.
Контекст без потери причины: оборачивание ошибок
Представьте сценарий создания задачи. Валидация обнаружила пустой заголовок, а прикладной метод передаёт ошибку наверх:
var ErrInvalidTaskTitle = errors.New("task title is required")

func validateTaskTitle(title string) error {
	if strings.TrimSpace(title) == "" {
		return ErrInvalidTaskTitle
	}

	return nil
}

func CreateTask(title string) (*Task, error) {
	if err := validateTaskTitle(title); err != nil {
		return nil, fmt.Errorf("create task: %w", err)
	}

	return &Task{
		Title: strings.TrimSpace(title),
	}, nil
}
Возвращённая ошибка напечатается так:
create task: task title is required
Это уже полезнее для диагностики: видно не только условие валидации, но и операцию, в которой оно возникло.
Ключевой элемент здесь — %w, а не %v.
fmt.Errorf("create task: %w", err)
%w создаёт новую ошибку, которая оборачивает исходную. Получается цепочка ошибок: верхний уровень хранит контекст текущей операции, а внутри остаётся исходная причина. Поэтому проверка продолжает работать:
task, err := CreateTask("   ")
if err != nil {
	if errors.Is(err, ErrInvalidTaskTitle) {
		fmt.Println("верните клиенту ошибку валидации")
	}
}

_ = task
Если бы вместо %w использовался %v, текст выглядел бы почти так же, но причина была бы потеряна для программной проверки:
// Плохо, если вызывающему коду важна исходная причина.
return nil, fmt.Errorf("create task: %v", err)
Используйте %v, только когда хотите добавить текст ошибки, но сознательно не хотите раскрывать её как часть контракта.
Working with Errors in Go 1.13
Прочитайте раздел официального Go Blog о границе между полезным оборачиванием и случайным раскрытием деталей реализации. Для backend-сервиса это особенно важно: ошибка драйвера базы данных не всегда должна становиться частью API прикладного слоя.
В разделе “Whether to Wrap” прочитайте его целиком. Начните с краткого правила: когда оборачивать. Затем проследите пример с sql.ErrNoRows: автор объясняет, почему обёрнутая низкоуровневая ошибка становится обещанием вашего API, которое будет трудно изменить при замене реализации хранилища.
Оборачивание формирует API
Оборачивать ошибку следует, когда вызывающему коду логично и нужно знать её первопричину.
Например, функция, которой передали io.Reader, может обернуть ошибку чтения: источник данных принадлежит вызывающему коду, поэтому его ошибка релевантна вызывающему коду.
Но представьте прикладной сценарий, который использует PostgreSQL внутри репозитория. Если наружу постоянно уходит обёрнутая ошибка конкретного драйвера базы данных, внешний код начинает зависеть от этой детали. Позже заменить библиотеку доступа к БД станет сложнее: клиенты уже могут проверять именно ошибку старого драйвера.
Практический принцип для будущего task manager:
- внутри инфраструктурного адаптера низкоуровневую ошибку можно проанализировать;
- на границе репозитория преобразуйте значимые условия в доменные ошибки, например
ErrTaskNotFound; - в прикладном слое добавляйте контекст операции с
%w, если эту доменную причину разрешено видеть выше; - в HTTP-слое позднее сопоставьте доменную ошибку с корректным статусом и единым JSON-ответом, не отдавая клиенту внутренние детали БД.
Не нужно оборачивать каждую строку кода. Контекст должен отвечать на вопрос: какая операция не удалась и над каким объектом? Сообщение вроде save task 101: %w полезно. Формулировка an error occurred: %w почти ничего не добавляет.
Когда нужен собственный тип ошибки
Sentinel error отвечает на вопрос: «какое состояние возникло?» Иногда этого недостаточно. Например, валидация может сообщать поле и причину, чтобы верхний слой сформировал структурированный ответ клиенту.
type FieldError struct {
	Field  string
	Reason string
}

func (e *FieldError) Error() string {
	return fmt.Sprintf("%s: %s", e.Field, e.Reason)
}
Теперь валидация создаёт новый экземпляр ошибки с данными:
func validateTaskTitle(title string) error {
	if strings.TrimSpace(title) == "" {
		return &FieldError{
			Field:  "title",
			Reason: "must not be empty",
		}
	}

	return nil
}
Прикладной метод может по-прежнему обернуть её:
func CreateTask(title string) (*Task, error) {
	if err := validateTaskTitle(title); err != nil {
		return nil, fmt.Errorf("create task: %w", err)
	}

	return &Task{
		Title: strings.TrimSpace(title),
	}, nil
}
Чтобы извлечь ошибку определённого типа из всей цепочки, используйте errors.As:
task, err := CreateTask("")
if err != nil {
	var fieldErr *FieldError

	if errors.As(err, &fieldErr) {
		fmt.Printf("field=%s reason=%s\n", fieldErr.Field, fieldErr.Reason)
	}
}

_ = task
Здесь fieldErr имеет тип *FieldError, поэтому в errors.As передаётся &fieldErr, то есть указатель на переменную, куда функция запишет найденное значение.
Выбор инструмента можно свести к простой модели:
| Задача вызывающего кода | Инструмент |
|---|---|
| Узнать фиксированное условие: «не найдено», «доступ запрещён», «заголовок пуст» | Sentinel error и errors.Is |
| Получить данные об ошибке: имя поля, лимит, идентификатор проблемного объекта | Собственный тип и errors.As |
| Добавить контекст, сохранив доступ к причине | fmt.Errorf с %w |
| Добавить текст, не раскрывая исходную реализацию как контракт | fmt.Errorf с %v |
Не создавайте отдельный тип для каждой ошибки. Если вызывающему коду достаточно одного из нескольких известных состояний, sentinel error проще. Тип оправдан, когда его поля действительно нужны для дальнейшего решения.
defer: зарегистрировать очистку сразу после получения ресурса
Ошибки сообщают, что операция не удалась. defer помогает гарантировать, что ресурс будет освобождён независимо от того, в какой точке функции произошёл выход.
Рассмотрим чтение файла:
func LoadTemplate(path string) ([]byte, error) {
	file, err := os.Open(path)
	if err != nil {
		return nil, fmt.Errorf("open template %q: %w", path, err)
	}
	defer file.Close()

	data, err := io.ReadAll(file)
	if err != nil {
		return nil, fmt.Errorf("read template %q: %w", path, err)
	}

	return data, nil
}
После успешного os.Open файл существует и его требуется закрыть. Поэтому defer file.Close() ставится сразу после проверки ошибки, а не в конце функции.
Если io.ReadAll завершится ошибкой, сработает return, затем выполнится отложенный file.Close(), и только после этого управление вернётся вызывающему коду. При успехе закрытие произойдёт перед обычным return data, nil.
Прочитайте начало статьи Defer, Panic, and Recover из официального Go Blog. Пример CopyFile хорошо показывает типичную ошибку в ручной очистке: один из ранних выходов оставляет файл открытым.
В начале статьи прочитайте объяснение defer и оба варианта CopyFile. В примере с ручным закрытием проследите пропущенную очистку, а затем сравните его с вариантом, где defer расположен сразу после успешного открытия каждого файла. Далее прочитайте все три правила до абзаца, начинающегося с “Panic is”. Особое внимание уделите правилу LIFO.
У defer три правила, которые нужно уверенно помнить и на собеседовании, и при чтении production-кода:
- Отложенный вызов выполняется при выходе из окружающей функции, а не сразу после строки
defer. - Аргументы отложенного вызова вычисляются в момент объявления
defer. - Несколько отложенных вызовов выполняются в порядке LIFO: последний зарегистрированный вызов выполняется первым.
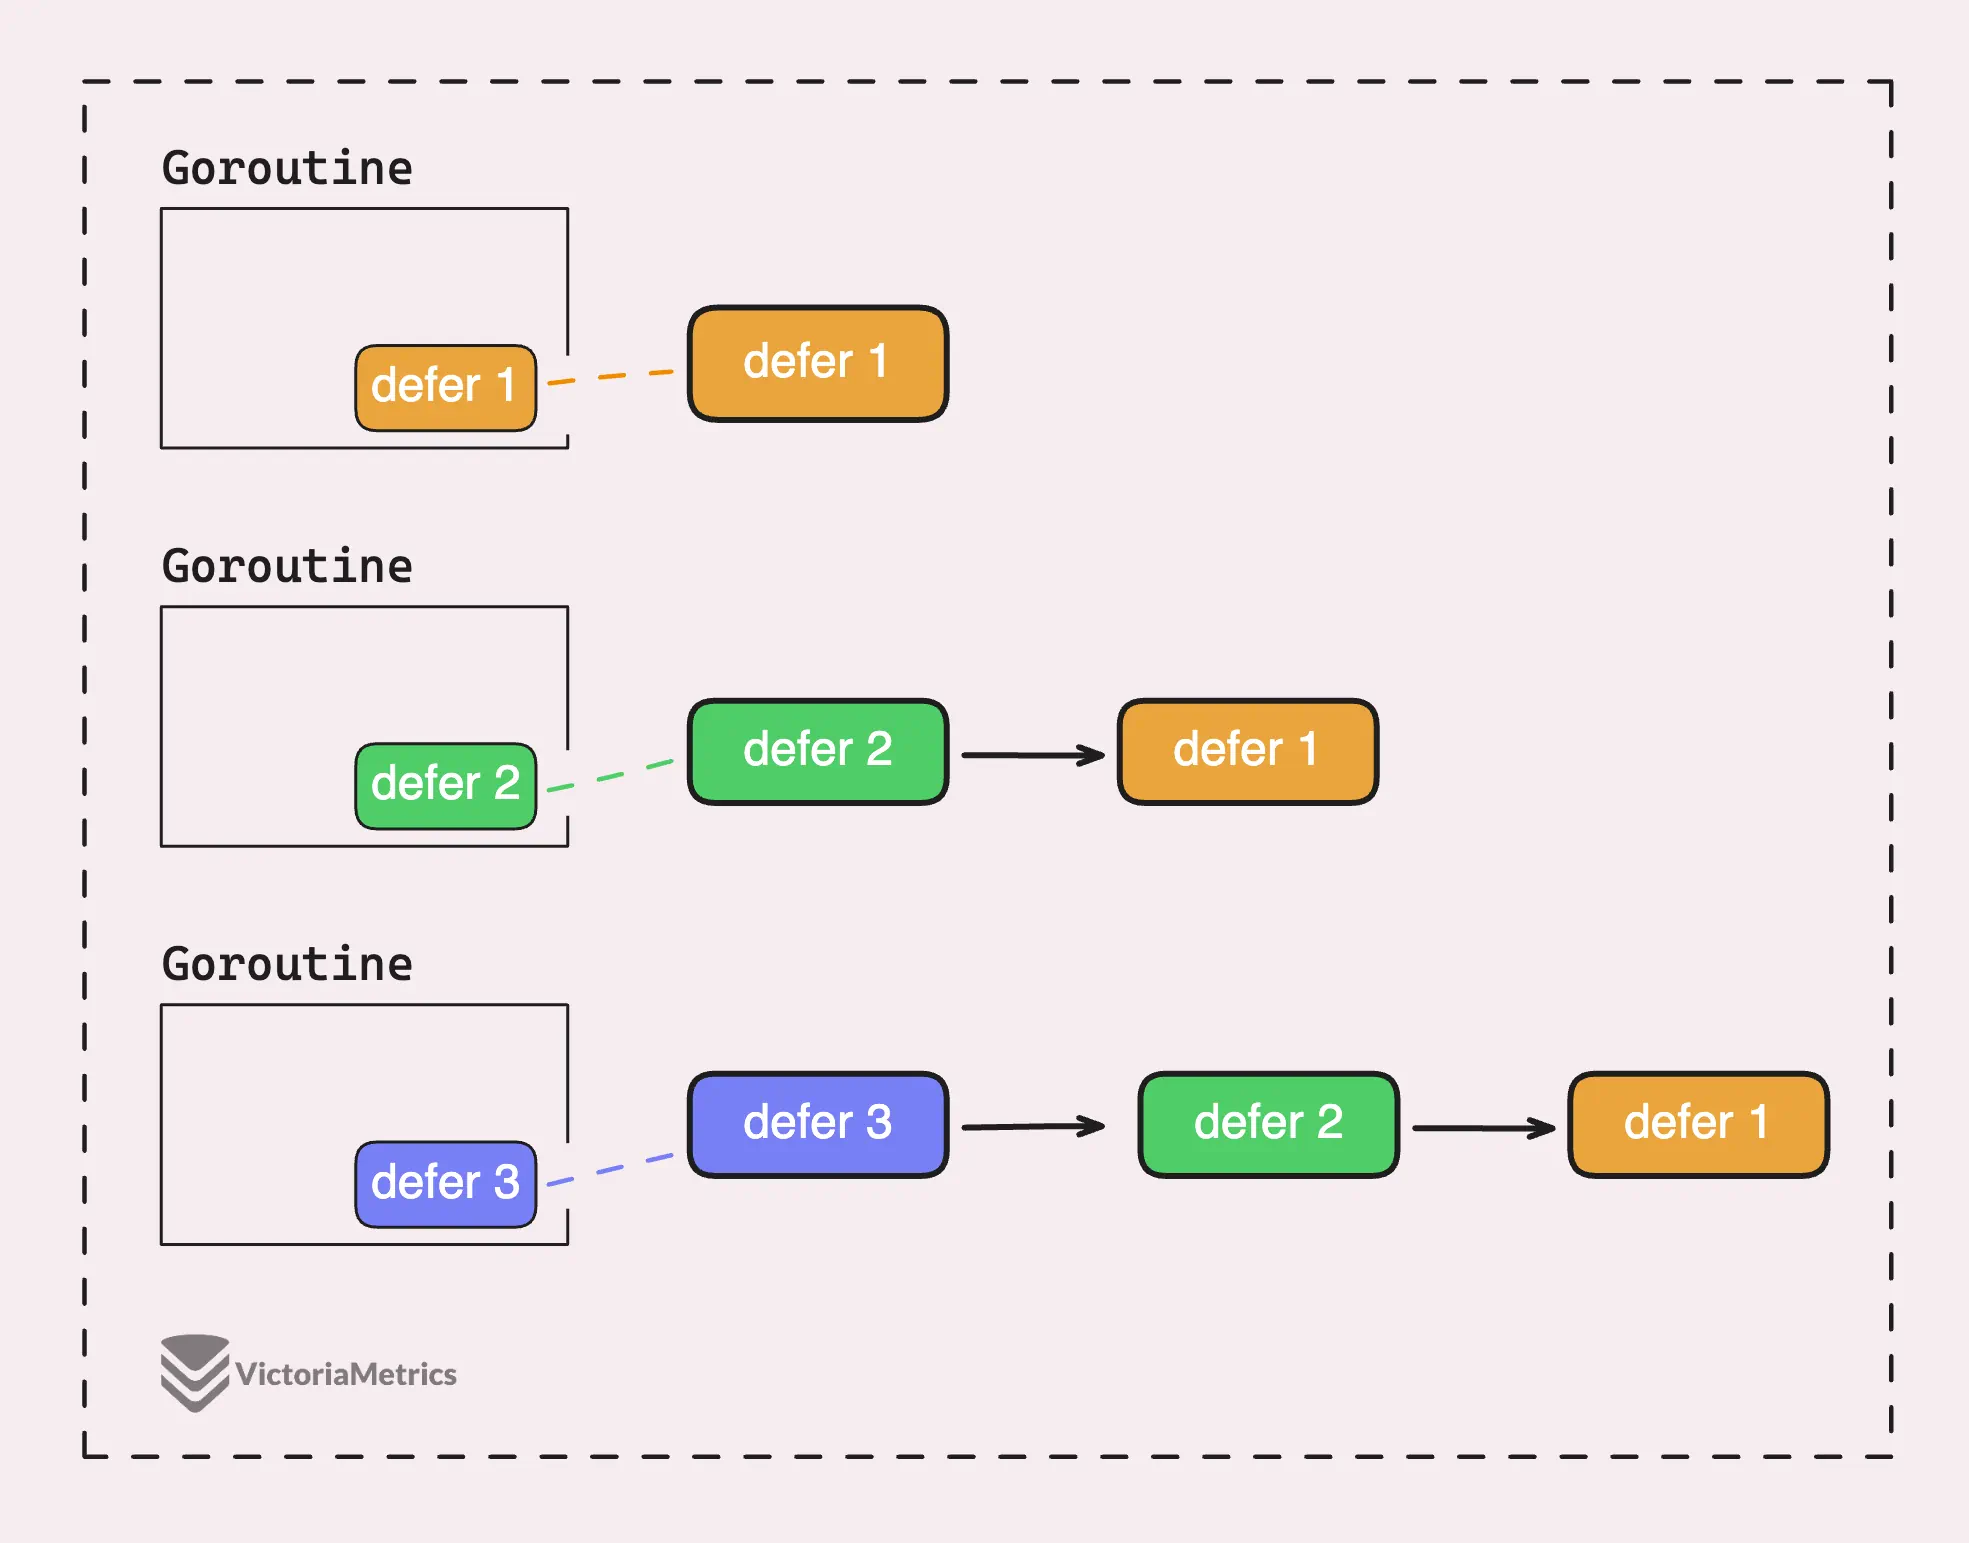
LIFO естественен для вложенных ресурсов. Если функция сначала открыла ресурс A, затем зависящий от него ресурс B, то закрывать их обычно нужно в обратном порядке. Достаточно поставить defer сразу после каждого успешного получения, и Go сделает это автоматически.
Аргументы вычисляются сейчас, а функция выполняется потом
Эти два фрагмента похожи, но выводят разное:
func first() {
	status := "opened"

	defer fmt.Println(status)

	status = "read"
}
first напечатает:
opened
Значение status было передано в fmt.Println в момент объявления defer.
Теперь вариант с замыканием:
func second() {
	status := "opened"

	defer func() {
		fmt.Println(status)
	}()

	status = "read"
}
second напечатает:
read
Анонимная функция обращается к переменной во время своего фактического выполнения, перед выходом из second.
Для обычной очистки ресурса часто достаточно простого варианта:
defer file.Close()
Он привязывает отложенный вызов к уже успешно открытому файлу. Замыкание полезно, когда при завершении нужно посмотреть на итоговое состояние функции, изменить именованный результат или обработать ошибку закрытия.
Не игнорируйте ошибку Close, если ресурс записывался
В примере чтения файла defer file.Close() намеренно игнорирует ошибку закрытия. Для чтения это часто допустимо: основная полезная операция уже завершилась в io.ReadAll.
При записи ситуация иная. Буферизированный ресурс может записать часть данных только во время Close, поэтому ошибка закрытия иногда означает, что операция записи фактически не завершилась.
Вот надёжный шаблон для операции записи:
func SaveReport(path string, data []byte) (err error) {
	file, err := os.Create(path)
	if err != nil {
		return fmt.Errorf("create report %q: %w", path, err)
	}

	defer func() {
		closeErr := file.Close()
		if err == nil && closeErr != nil {
			err = fmt.Errorf("close report %q: %w", path, closeErr)
		}
	}()

	_, err = file.Write(data)
	if err != nil {
		return fmt.Errorf("write report %q: %w", path, err)
	}

	return nil
}
Здесь у функции именованный результат err. Последовательность работы такова:
os.Createполучает файл или сразу возвращает ошибку.- После успешного открытия регистрируется отложенное закрытие.
- Если
file.Writeне удалось, функция возвращает ошибку записи. - Отложенная функция запускается перед окончательным возвратом.
- Ошибка
Closeподменяет результат, только если основной операции не было ошибки.
Это условие принципиально. Если Write уже вернул ошибку, она обычно лучше объясняет первичный сбой. Не стоит затирать её вторичной ошибкой очистки.
Два частых промаха с defer
Первый промах: defer до проверки получения ресурса.
file, err := os.Open(path)
defer file.Close() // небезопасно
if err != nil {
	return nil, err
}
Если открыть файл не удалось, file может быть nil, и отложенный вызов приведёт к проблеме. Верный порядок всегда такой: получить ресурс, проверить ошибку, зарегистрировать очистку.
Второй промах: defer внутри долгого цикла.
for _, path := range paths {
	file, err := os.Open(path)
	if err != nil {
		return err
	}
	defer file.Close()

	// обработка file
}
Все файлы останутся открытыми до выхода из внешней функции. При большом числе элементов это может исчерпать лимит файловых дескрипторов.
Лучше вынести обработку одного элемента в отдельную функцию. Её defer сработает после каждой итерации:
func ProcessAll(paths []string) error {
	for _, path := range paths {
		if err := processOne(path); err != nil {
			return err
		}
	}

	return nil
}

func processOne(path string) error {
	file, err := os.Open(path)
	if err != nil {
		return fmt.Errorf("open %q: %w", path, err)
	}
	defer file.Close()

	// обработка одного файла
	return nil
}
Тот же принцип позднее пригодится для mu.Lock() и defer mu.Unlock(), транзакций, ответов HTTP-клиента и других ресурсов. defer не заменяет обработку ошибок, но делает парную операцию очистки локальной и заметной: ресурс получен, его освобождение сразу зарегистрировано.
Итоги
Сегодня вы восстановили идиоматичную схему работы с ошибками и очисткой ресурсов в Go:
error— обычное возвращаемое значение; проверяйте его сразу после вызова;errors.Newподходит для фиксированных условий, которые удобно проверять как sentinel errors;errors.Isищет известную причину по всей цепочке обёрнутых ошибок;- собственный тип ошибки хранит структурированные данные, а
errors.Asизвлекает его из цепочки; fmt.Errorfс%wдобавляет контекст и сохраняет исходную ошибку;- решение оборачивать ошибку влияет на публичный контракт вашего пакета: не раскрывайте случайно детали инфраструктуры;
deferрегистрируйте сразу после успешного получения ресурса;- отложенные вызовы выполняются при выходе из функции в порядке LIFO;
- для операций записи учитывайте ошибку
Close, не затирая более важную основную ошибку; - не размещайте
deferвнутри длинного цикла, если ресурс должен освобождаться на каждой итерации.
В следующем уроке вы начнёте организовывать код по пакетам: разберёте правила экспорта, направленность зависимостей и структуру небольшого Go-приложения.
Can't find a good explanation? Sign up and we'll make it for you
Sign up