
مرحبًا مجددًا. في الدرس السابق تعلّمت أن صف البايتات الظاهر في محرر Hex ليس دائمًا رقمًا يُقرأ من اليسار إلى اليمين؛ فالقيم متعددة البايتات في Windows تُفسَّر غالبًا بترتيب Little-endian. الآن سنستخدم الفكرة نفسها بطريقة مختلفة: بدل أن نعامل البايتات كأعداد، سنسأل متى تكون هذه البايتات نصًا، وأي ترميز نصي قد تستخدمه، ومتى تكون مجرد بيانات خام.
خلال نحو 40–45 دقيقة، ستتدرب على قراءة أعمدة Hex والنص في محرر مثل HxD، والتمييز بين ASCII وUTF-8 وUTF-16LE، واستخدام BOM والأنماط المتكررة والبحث النصي كأدلة. هذه مهارة مهمة جدًا قبل أن تستنتج وظيفة برنامج من نصوصه، أو تبحث عن أسماء ملفات ودوال ورسائل أخطاء داخل ملف PE أو ذاكرة عملية.
البايتات لا تحمل بطاقة تعريف
محرر Hex يعرض حقيقة واحدة مؤكدة: البايتات الموجودة. أما “هذا نص” أو “هذه قيمة عددية” أو “هذه بنية ملف” فهو تفسير يعتمد على السياق.
مثلًا، التسلسل التالي:
48 65 6C 6C 6F
يمكن تفسيره كنص Hello باستخدام ASCII، ويمكن تفسيره أيضًا كنص Hello باستخدام UTF-8. لكنه قد يظهر، من حيث المبدأ، داخل بيانات ثنائية لا علاقة لها برسالة نصية مقصودة. لذلك لا تقل فورًا: “وجدت نصًا إذن الملف نصي”. الأدق هو:
وجدت تسلسل بايتات قابلًا للقراءة كنص، ويحتاج معنى هذا التسلسل إلى دليل من موقعه والسياق المحيط به.
الهدف في التحليل العكسي ليس تخمين الترميز من بايت واحد، بل بناء حكم مبني على عدة أدلة:
- بداية الملف أو البنية المعروفة: هل توجد بصمة ترميز مثل BOM؟
- شكل البايتات: هل تبدو كأحرف قابلة للطباعة؟ هل يتكرر
00كل بايتين؟ - سلامة فك الترميز: هل تتحول المنطقة إلى نص مفهوم دون رموز بديلة أو أخطاء؟
- السياق: هل النص قريب من أسماء ملفات، مسارات، رسائل واجهة، أو مفاتيح إعدادات؟
- الأداة أو مواصفة التنسيق: هل يذكر برنامج التحليل أو صيغة الملف ترميزًا محددًا؟
شاهد أولًا المقطع التمهيدي من فيديو How Computers Store Text لقناة NoBS Code. لا تحتاج في هذه المرحلة إلى حفظ تفاصيل تحويل كل رمز إلى بتات؛ ركّز على الفصل بين معيار Unicode وبين طرق تخزينه مثل UTF-8 وUTF-16.
How Computers Store Text - ASCII, Unicode, UTF-8, UTF-16, and UTF-32
يعرض فيديو How Computers Store Text — ASCII, Unicode, UTF-8, UTF-16, and UTF-32 من قناة NoBS Code الفكرة الأساسية: النص يتحول إلى أرقام، ثم يعاد تفسير الأرقام كنص.
شاهد فكرة الترميز لتثبيت الفرق بين encoding وdecoding. ثم تابع ASCII وحدوده، وUnicode والنقاط. ركز على أن ASCII محدود، وأن Unicode يحدد رموزًا عالمية بدل أن يكون مجرد “نص إنجليزي موسع”.
ASCII: أبسط نمط نصي ستصادفه
ASCII الأصلي معيار من 7 بتات، أي إنه يغطي القيم من 00 إلى 7F. في العمل العملي مع محرر Hex، أهم جزء منه هو النطاق القابل للطباعة غالبًا:
| النطاق السداسي عشري | أمثلة |
|---|---|
20 | مسافة |
30 إلى 39 | الأرقام 0 إلى 9 |
41 إلى 5A | الأحرف الكبيرة A إلى Z |
61 إلى 7A | الأحرف الصغيرة a إلى z |
مثلًا، السلسلة:
55 73 65 72 3D 41 6C 69
تُقرأ:
User=Ali
لأن:
55 = U
73 = s
65 = e
72 = r
3D = =
41 = A
6C = l
69 = i
في محرر Hex ستظهر هذه الأحرف غالبًا في عمود النص الموجود إلى يمين البايتات. أما البايتات غير القابلة للطباعة فيمثلها المحرر عادة بنقطة . أو رمز بديل.
لا تخلط بين 0 و00
هذا فرق مهم عند فحص نصوص البرامج:
30
هو الحرف المرئي 0، أي الرقم صفر في ASCII.
أما:
00
فهو NUL، محرف تحكم قيمته صفر. في كثير من سلاسل C التقليدية، يستخدم 00 كعلامة نهاية للسلسلة النصية:
48 65 6C 6C 6F 00
 H  e  l  l  o \0
أي أن البرنامج قد يقرأ Hello ثم يتوقف عند 00.
لكن لا تجعل هذا استنتاجًا آليًا: وجود 00 لا يعني دائمًا “نهاية نص”. قد يكون جزءًا من عدد Little-endian أو حقل فارغ أو محاذاة أو بيانات ثنائية عادية. السياق هو الذي يحدد وظيفته.
لا تسمِّ البايتات ذات القيمة
80إلىFF“ASCII موسعًا” وكأنها معيار واحد. توجد ترميزات تاريخية متعددة تستخدم تلك القيم بطرق مختلفة. في التحليل الحديث، افحص احتمال UTF-8 أو UTF-16 أو بيانات خام بدل افتراض جدول موسع مجهول.
Unicode ليس ترميزًا واحدًا
Unicode هو نظام يعيّن رقمًا لكل رمز، يسمى نقطة كود. أما UTF-8 وUTF-16 وUTF-32 فهي طرق مختلفة لتحويل تلك النقاط إلى بايتات فعلية.
اقرأ هذه الأجزاء القصيرة من صفحة UTF-8, UTF-16, UTF-32 & BOM الرسمية من Unicode Consortium. ستساعدك في استخدام المصطلحات بدقة، خصوصًا عند كتابة ملاحظات التحليل لاحقًا.
FAQ - UTF-8, UTF-16, UTF-32 & BOM
صفحة الأسئلة الشائعة الرسمية من Unicode Consortium تشرح الفرق بين Unicode كمعيار وبين صيغ UTF التي قد تراها فعليًا كبايتات داخل الملفات والذاكرة.
في قسم General questions, relating to UTF or Encoding Form، ابدأ من سؤال “Is Unicode a 16-bit encoding?” واقرأ فرق التمثيلات. ثم في سؤال “What are some of the differences between the UTFs?” راجع الجدول، وبخاصة حجم وحدة الترميز وترتيب البايتات في UTF-16LE وUTF-16BE. في السؤال “Why do some of the UTFs have a BE or LE in their label?”، ركز على أن UTF-16LE يستخدم Little-endian، ثم اقرأ توافق UTF-8 لفهم سبب ظهور النص الإنجليزي بالبايتات نفسها في ASCII وUTF-8. وأخيرًا، في قسم Byte Order Mark (BOM) FAQ انتقل إلى سؤال “Is a BOM used only in 16-bit Unicode text?” واقرأ جدول البصمات الذي يليه. لاحظ كذلك دور BOM في UTF-8.
UTF-8: ASCII زائد نص عالمي
UTF-8 هو الترميز الأكثر شيوعًا في الويب وكثير من الملفات الحديثة. أهم قاعدة عملية:
كل نص ASCII صالح أيضًا بوصفه UTF-8، وبنفس البايتات.
لذلك:
48 65 6C 6C 6F
يمكن أن يكون ASCII أو UTF-8. لا تستطيع التمييز يقينًا بينهما من هذه الأحرف وحدها. في ملاحظاتك، اكتب مثلًا:
ASCII-compatible text; could also be UTF-8.
عندما تظهر أحرف خارج ASCII، يستخدم UTF-8 أكثر من بايت للحرف. مثلًا، النص:
User=علي
يبدأ في UTF-8 بالبايتات المعتادة للنص اللاتيني:
55 73 65 72 3D
ثم تظهر بايتات متعددة لكل حرف عربي. لا يلزمك حفظ قيم الحروف العربية الآن؛ المهم أن تعرف أن عمود ASCII قد يعرض نقاطًا أو رموزًا غير مفهومة، بينما يعرض المحرر النص بصورة صحيحة عند اختياره UTF-8.
قد يبدأ ملف UTF-8 أحيانًا بالبصمة:
EF BB BF
لكن غيابها لا يعني أن الملف ليس UTF-8؛ كثير من ملفات UTF-8 لا تحتوي BOM.
UTF-16LE: نمط شائع في بيئة Windows
UTF-16 يستخدم وحدات من بايتين. ولهذا يحتاج إلى تحديد ترتيب البايتات: LE أو BE.
في UTF-16LE، يمثل النص اللاتيني البسيط غالبًا بهذا الشكل:
48 00 65 00 6C 00 6C 00 6F 00
 H     e     l     l     o
كل حرف لاتيني هنا يشغل بايتين، والبايت الثاني يساوي 00. هذا يخلق نمطًا بصريًا واضحًا: حرف قابل للطباعة، ثم صفر، بشكل متكرر.
تظهر بداية UTF-16LE أحيانًا هكذا:
FF FE
وهي BOM الخاصة به. بعد ذلك قد ترى:
FF FE 48 00 65 00 6C 00 6C 00 6F 00
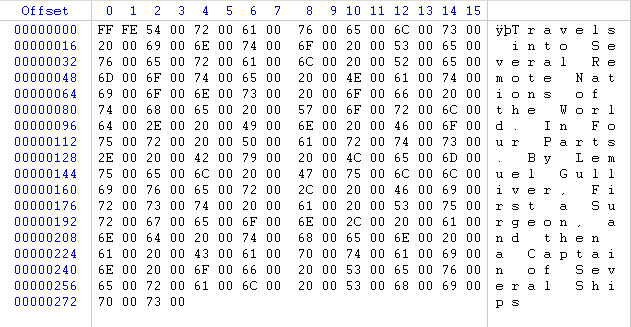
اربط ذلك بما تعلمته في الدرس السابق: 48 00 هو تمثيل Little-endian لوحدة UTF-16 قيمتها 0x0048، أي الحرف H. لكن لا تعكس ترتيب حروف النص؛ أنت تفسر كل وحدة من بايتين وفق ترتيبها، ثم تقرأ الحروف بترتيب مواضعها الطبيعي.
هناك قيد مهم على نمط الأصفار: هو واضح خصوصًا للنص اللاتيني. النص العربي أو الياباني في UTF-16LE لا يضمن تكرار 00 بعد كل حرف، لأن قيم نقاط الكود الخاصة به ليست ضمن النطاق اللاتيني البسيط. لذلك:
- وجود النمط
حرف، 00، حرف، 00دليل قوي على UTF-16LE لنص لاتيني. - غياب هذا النمط لا ينفي UTF-16LE، خصوصًا عند وجود لغات غير لاتينية.
بصمات BOM المفيدة
احفظ هذه البصمات كدليل افتتاحي قوي، لا كقاعدة وحيدة:
| أول البايتات في الملف | التفسير المحتمل |
|---|---|
EF BB BF | UTF-8 مع BOM |
FF FE | UTF-16LE مع BOM |
FE FF | UTF-16BE مع BOM |
FF FE 00 00 | UTF-32LE مع BOM |
00 00 FE FF | UTF-32BE مع BOM |
عند رؤية FF FE 00 00، افحص أربعة بايتات لا اثنين فقط؛ فهي بصمة UTF-32LE الكاملة، وليست مجرد UTF-16LE يجب أن تتوقف قراءته عند أول بايتين.
ولا تنسَ أن BOM تكون في بداية تدفق النص عادةً. العثور على هذه البايتات في منتصف ملف عشوائي لا يكفي وحده للجزم بأن المنطقة بداية نص Unicode.
كيف تميّز البيانات الخام عمليًا؟
البيانات الخام لا تعني بالضرورة “قمامة” أو “تشفير”. تعني فقط أنك لا تملك دليلًا جيدًا على أنها نص بترميز محدد.
قد تكون المنطقة الخام:
- عددًا أو عنوانًا أو علمًا.
- صورة أو صوتًا أو موردًا مضمنًا.
- تعليمات آلة.
- جدولًا أو بنية بيانات.
- بيانات مضغوطة أو مشفرة.
- ملفًا يحتوي نصوصًا متفرقة بين حقول ثنائية.
هذه إشارات معقولة إلى أن المنطقة ليست نصًا مستمرًا:
- كثرة البايتات غير القابلة للطباعة دون نمط UTF-8 صالح أو نمط UTF-16 واضح.
- قيم تتغير كل 2 أو 4 أو 8 بايتات بطريقة تناسب حقولًا عددية.
- تكرار سجلات ثابتة الطول.
- وجود نص قصير مفيد محاط ببايتات غير مفهومة.
- عرض نفس المنطقة كـ UTF-8 أو UTF-16 وإنتاج رموز عشوائية أو نص غير مترابط.
لكن انتبه إلى القاعدة المقابلة أيضًا:
ملف ثنائي قد يحتوي على نصوص حقيقية داخله.
مثلًا، ملف PE تنفيذي ليس ملفًا نصيًا، لكنه قد يحتوي على رسائل أخطاء، مسارات DLL، أسماء دوال مستوردة، عناوين URL، ومفاتيح إعدادات. ستستخدم هذه النصوص لاحقًا كخيوط أولية لفهم وظيفة البرنامج، لكنك لن تعتبر الملف كله “ASCII” لمجرد أن كلمة مثل CreateFileW ظهرت فيه.
البحث عن النصوص: ابحث بأكثر من ترميز
لا تعتمد فقط على عمود النص في محرر Hex. بعض المحررات تعرض العمود بوصفه ASCII افتراضيًا؛ لذلك قد تخفي عنك نص UTF-16LE أو تعرضه مع نقاط بين الحروف.
استخدم وظيفة البحث النصي في المحرر وفق هذا التسلسل:
- ابحث عن كلمة متوقعة بصيغة ASCII أو UTF-8، مثل
Userأوhttpأو.dll. - إن لم تجدها وكانت لديك أسباب للاشتباه ببرنامج Windows أو .NET، ابحث عن النسخة Unicode أو UTF-16.
- بعد العثور على نتيجة، افحص البايتات قبلها وبعدها.
- حدد هل هي سلسلة مستقلة، وهل تنتهي بـ
00أو بـ00 00، وهل النص حولها مفهوم. - سجّل الترميز المفترض ومستوى الثقة بدل الاكتفاء بكتابة النص المقروء.

مثال على ملاحظة تحليل مفيدة:
Offset: 0x00001A40
Raw bytes: 46 69 6C 65 4E 61 6D 65 00
Decoded text: FileName
Candidate encoding: ASCII-compatible / UTF-8
Boundary: null byte follows the text
Confidence: medium; readable standalone string in a binary file.
ومثال UTF-16LE:
Offset: 0x00002210
Raw bytes: 46 00 69 00 6C 00 65 00 00 00
Decoded text: File
Candidate encoding: UTF-16LE
Boundary: UTF-16 null terminator
Confidence: high; alternating zero pattern and valid Unicode decoding.
مختبر عملي: أنشئ أربع عينات وافحصها
خصص 15–20 دقيقة. استخدم فقط هذه الملفات التدريبية التي ستنشئها بنفسك داخل الآلة الافتراضية. لا تعدّل ملفات تنفيذية أو ملفات حفظ أصلية أثناء التدريب.
افتح PowerShell في مجلد عمل جديد، ثم نفذ:
New-Item -ItemType Directory -Force .\text-hex-lab | Out-Null
Set-Location .\text-hex-lab

$ascii = [System.Text.Encoding]::ASCII
$utf8 = [System.Text.UTF8Encoding]::new($false)
$utf16le = [System.Text.Encoding]::Unicode

[System.IO.File]::WriteAllBytes(
    "$PWD\ascii.bin",
    $ascii.GetBytes("User=Ali`nScore=42")
)

[System.IO.File]::WriteAllBytes(
    "$PWD\utf8.bin",
    $utf8.GetBytes("User=علي; Score=42")
)

$utf16Bytes = [byte[]](
    $utf16le.GetPreamble() +
    $utf16le.GetBytes("User=Ali; Score=42")
)

[System.IO.File]::WriteAllBytes(
    "$PWD\utf16le.bin",
    $utf16Bytes
)

$raw = [byte[]](
    0x4D,0x5A,0x90,0x00,0x03,0x00,0x00,0x00,
    0x48,0x65,0x6C,0x6C,0x6F,0x00,0xFF,0x10
)

[System.IO.File]::WriteAllBytes(
    "$PWD\raw.bin",
    $raw
)

Format-Hex .\ascii.bin
Format-Hex .\utf8.bin
Format-Hex .\utf16le.bin
Format-Hex .\raw.bin
الملف raw.bin ليس ملف PE صالحًا؛ بدأناه فقط ببايتات مشابهة لبداية بعض الملفات الثنائية ثم أضفنا داخله النص Hello. الغرض هو إثبات أن وجود نص قابل للقراءة لا يحوّل المنطقة أو الملف تلقائيًا إلى “ملف نصي”.
افتح الملفات الأربعة في HxD أو محرر Hex مشابه، من دون حفظ أي تعديل. راقب النمط التالي:
| الملف | ما تتوقع رؤيته | التصنيف الصحيح |
|---|---|---|
ascii.bin | بايت واحد قابل للقراءة لكل حرف | ASCII؛ وصالح أيضًا كـUTF-8 |
utf8.bin | User= واضح، ثم بايتات متعددة للأحرف العربية | UTF-8 |
utf16le.bin | FF FE في البداية، ثم حروف إنجليزية تفصلها 00 | UTF-16LE مع BOM |
raw.bin | بايتات مختلطة، مع ظهور Hello في موضع محدود | بيانات خام تحتوي سلسلة ASCII مضمنة |
نفّذ البحث النصي داخل المحرر بهذه الطريقة:
- في
ascii.bin، ابحث عنScoreبصيغة ASCII. - في
utf8.bin، ابحث عنUser=بصيغة ASCII، ثم راقب البايتات التي تلي علامة=. - في
utf16le.bin، ابحث عنUserباستخدام خيار Unicode أو UTF-16 إن كان متاحًا. - في
raw.bin، ابحث عنHelloبصيغة ASCII، ثم افحص ثمانية بايتات قبله وبعده؛ ستلاحظ أن السلسلة مجرد جزء صغير داخل منطقة ثنائية.
عند الانتهاء، اكتب لنفسك سطرًا واحدًا لكل ملف يتضمن: اسم الملف، تسلسل البايتات المميز، الترميز أو التصنيف، وسبب الحكم. هذه العادة ستتحول لاحقًا إلى ملاحظات تحليل قابلة للمراجعة بدل انطباعات سريعة.
خلاصة
أصبحت الآن قادرًا على التعامل مع النص في محرر Hex بوصفه فرضية قابلة للتحقق لا بوصفه مجرد ما يظهر في عمود النص:
- ASCII يستخدم بايتًا واحدًا للأحرف الأصلية، و
00ليس الحرف0بل NUL. - أي نص ASCII صالح أيضًا بوصفه UTF-8؛ لذلك لا يمكن التمييز بينهما دائمًا من النص اللاتيني وحده.
- Unicode معيار للرموز، أما UTF-8 وUTF-16 وUTF-32 فهي طرق لتحويلها إلى بايتات.
- UTF-16LE شائع في Windows، ويظهر النص اللاتيني فيه غالبًا بنمط حرف ثم
00. - بصمات BOM مثل
EF BB BFوFF FEأدلة قوية عند بداية الملف، لكنها ليست بديلًا عن فحص السياق. - البيانات الثنائية قد تحتوي سلاسل نصية مفيدة؛ العثور على نص لا يعني أن الملف كله نص.
- لا تعكس بايتات ASCII أو UTF-8. ويقتصر أثر Little-endian هنا على وحدات UTF-16 أو UTF-32 متعددة البايتات.
في الدرس التالي ستنتقل إلى بصمة SHA-256: ستتعلم كيف تحسبها لملف وكيف تستخدمها للتحقق من هويته وسلامته قبل بدء التحليل.
Can't find a good explanation? Sign up and we'll make it for you
Sign up