
Здравствуйте! Начинаем курс с самого малого объекта теории информации: не со средней неопределённости распределения, а с информации, принесённой одним наблюдённым событием. В этом модуле мы постепенно перейдём от этой величины к энтропии Шеннона, условной энтропии и цепным правилам.
Сегодняшняя цель фундаментальна: показать, что формула
не является произвольным соглашением. Если мера «удивления» зависит от вероятности события, возрастает для более редких событий и складывается для независимых наблюдений, то она неизбежно имеет логарифмический вид — с точностью до выбора масштаба, то есть единицы измерения.
От «удивления» к функциональному уравнению
Пусть событие имеет вероятность
Ищем функцию , которая измеряет собственную информацию, или surprisal, наблюдения этого события:
Здесь уже заложено важное предположение: содержание информации зависит только от вероятности, а не от семантической метки события. Если модель считала токен Paris вероятностью , то факт его появления несёт столько же self-information, сколько появление любого другого события с вероятностью .
Потребуем от три естественных свойства.
-
Достоверное событие не сообщает нового.
Если событие ожидалось с вероятностью , его наступление не меняет знания наблюдателя.
-
Редкое событие информативнее частого. Функция должна быть строго убывающей по :
-
Независимые наблюдения должны складываться по информации. Если и независимы, то
Узнать оба результата должно означать получить сумму информации:
Поэтому для любых допустимых необходимо
Последнее равенство — центральное функциональное уравнение. Вероятности независимых событий перемножаются, а информация о них должна складываться. Логарифм — именно та операция, которая переводит произведение в сумму.
MaDL - Information and Entropy
Посмотрите фрагмент «MaDL – Information and Entropy» от Tübingen Machine Learning. Он коротко и наглядно формулирует требования к собственной информации, затем проверяет их на бросках монеты.
В отрывке аксиомы обратите внимание на три требования: нулевую информацию при вероятности один, убывание по вероятности и аддитивность независимых событий. Затем посмотрите пример монеты, чтобы зафиксировать, почему два независимых равновероятных результата дают два бита, а не некоторую новую произвольную шкалу.
Обычная интуиция «редкое значит информативное» сама по себе ещё не фиксирует формулу. Например,
тоже убывает по и даёт ноль при . Но она не согласуется с композицией независимых наблюдений:
То есть она неверно измеряет «объём» двух независимых фактов. Аддитивность резко сужает пространство возможных мер.
Вывод: монотонное решение обязано быть логарифмом
Теперь выведем форму аккуратно, не просто проверим её постфактум.
Из аддитивности сразу следует нормировка для достоверного события:
откуда
Чтобы превратить умножение вероятностей в сложение аргументов, введём новую функцию:
Это не трюк, а естественная замена координат: любая вероятность единственным образом представляется как
Подставим и в аддитивность:
Итак, удовлетворяет аддитивному уравнению Коши на неотрицательной полуоси:
Само по себе уравнение Коши допускает патологические решения, если не накладывать никаких условий регулярности. Здесь регулярность уже даёт наша содержательная аксиома монотонности:
- строго убывает по ;
- строго убывает по ;
- следовательно, строго возрастает по .
Монотонной аддитивной функции достаточно, чтобы получить линейность. Обозначим
Тогда для натурального
Для рационального числа имеем
значит,
Наконец, рациональные числа можно приблизить к любому вещественному снизу и сверху. Монотонность зажимает между соответствующими значениями на рациональных приближениях. Поскольку на рациональных аргументах функция уже равна , получаем для всех :
Возвращаемся к вероятности. Так как ,
Строгое убывание требует . Следовательно, единственное семейство мер собственной информации, согласованных с аксиомами, имеет вид
для некоторой положительной константы .
Эту константу удобнее записать как выбор основания логарифма. Если выбрать так, что
то получаем привычную форму:
Information content - Wikipedia
Прочитайте раздел «Derivation» из статьи Information content на Wikipedia. Он повторяет аксиоматическую мотивацию через функциональное уравнение и явно связывает множитель перед логарифмом с выбором единицы измерения.
В подразделе “Derivation” начните с абзаца, который вводит зависимость информации от вероятности: постановка функции. Затем найдите абзац, начинающийся словами “Further, by definition” и прочитайте переход к аддитивности: независимость превращает совместную вероятность в произведение. Закончите абзацами от “The only continuous functions”, где дано логарифмическое решение и обсуждается выбор основания. В источнике регулярность формулируется как непрерывность; в нашем выводе ту же техническую роль играет более содержательное условие монотонности.
Масштаб информации: биты, наты и нормировка
После вывода остаётся свобода масштаба. Она не меняет сравнений и аддитивности, но меняет численное значение информации.
| Основание | Нормировка | Единица |
|---|---|---|
| бит | ||
| нат | ||
| хартли |
В ML наиболее часто встречаются две конвенции:
- наты, когда loss записан через естественный логарифм, как в большинстве библиотек и выводов правдоподобия;
- биты, когда важна интерпретация через двоичные вопросы, сжатие или bits per token.
Перевод между ними — обычное изменение масштаба:
Например, событие с вероятностью имеет информацию
бит, или
ната. Это одно и то же наблюдение в разных единицах.
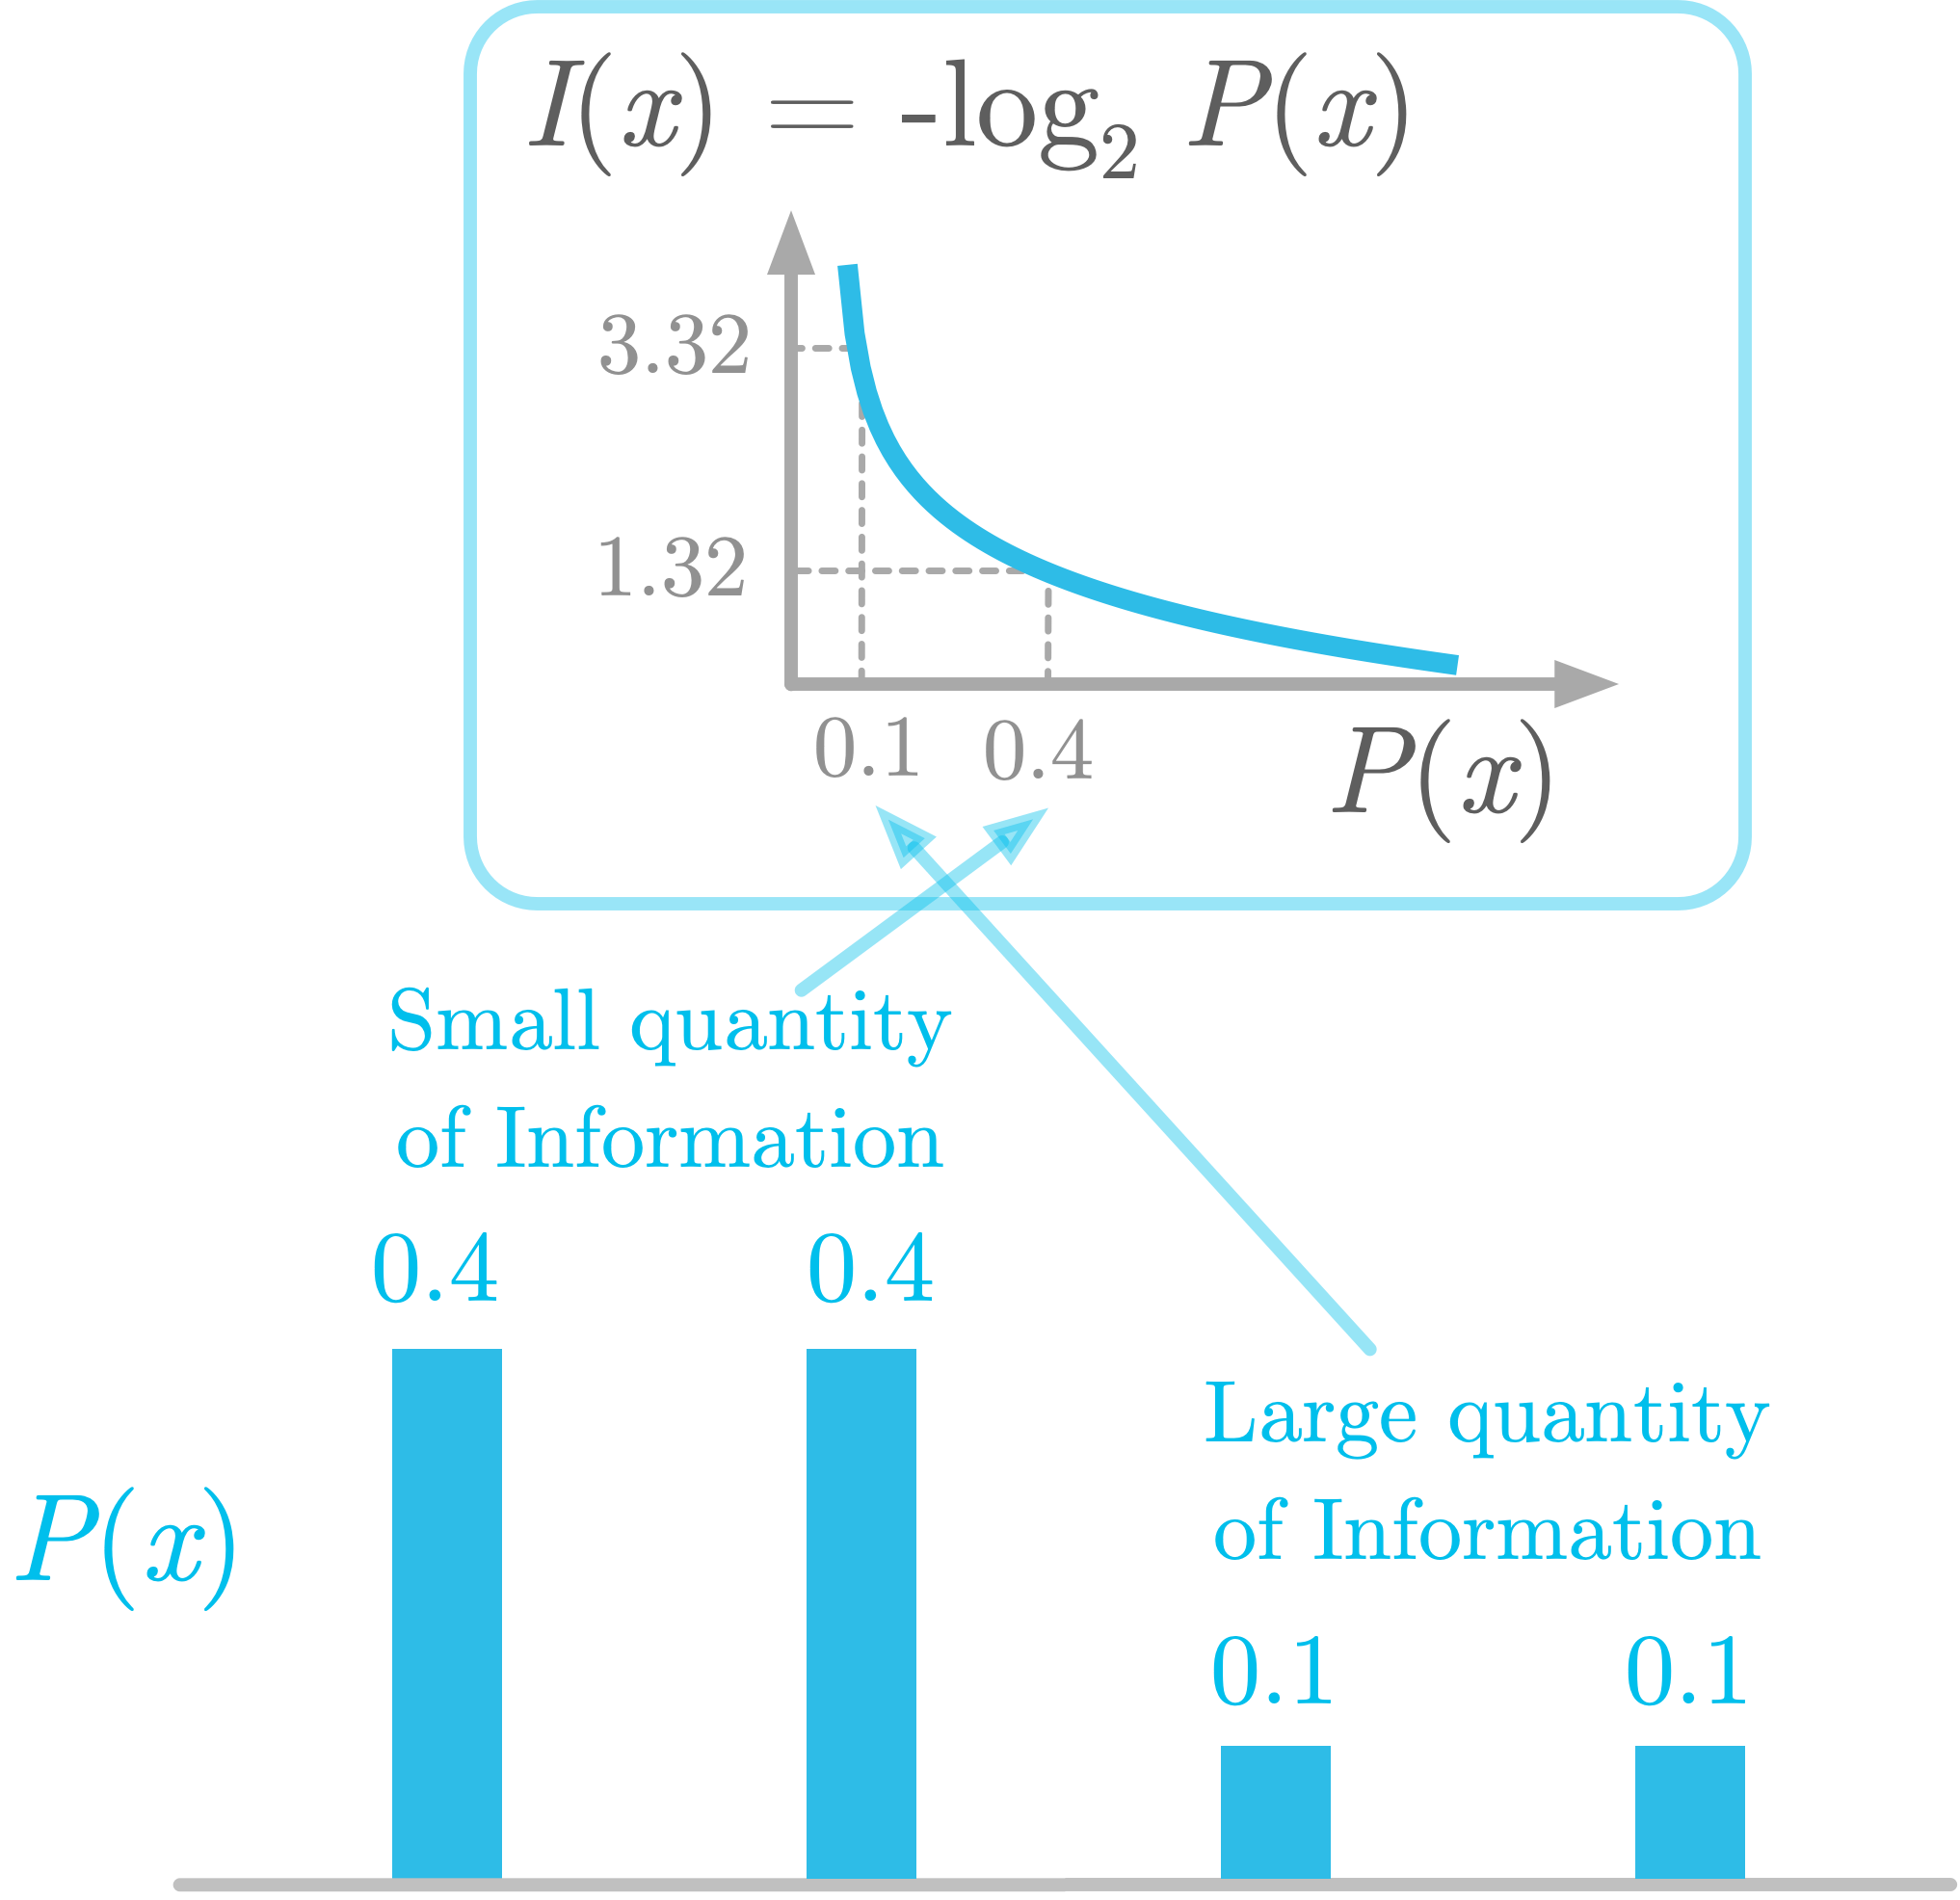
Важны и граничные случаи:
При собственная информация неограниченно растёт:
Строго говоря, не определён. Интерпретация предела такова: если модель приписала реализовавшемуся событию нулевую вероятность, наблюдение бесконечно сильно противоречит модели. В реальных нейросетевых моделях softmax обычно оставляет вероятности положительными, но численно очень малые вероятности уже соответствуют большим отрицательным log-probability и большим loss.
Почему это уже язык ML
Для модели, предсказывающей категориальное распределение , собственная информация наблюдённого класса равна
Это и есть negative log-likelihood для одного наблюдения. Она не оценивает качество модели в среднем и ещё не является энтропией: это стоимость конкретного факта, который модель заранее считала вероятностью .
Логарифм особенно важен для последовательностей. Если авторегрессионная модель задаёт вероятность текста через условные вероятности, то вероятность всей последовательности равна произведению:
Взяв отрицательный логарифм, получаем сумму token-level surprisals:
Здесь не предполагается независимость токенов: зависимость учтена через условный контекст . Полный разбор этого равенства для language models появится в модуле об энтропии и оценке языковых моделей; пока существенен принцип: логарифм делает вероятностную композицию аддитивной и поэтому превращает likelihood последовательности в удобную сумму оптимизационных слагаемых.
Небольшая проверка на Python фиксирует это свойство численно:
import math

def surprisal(p: float, base: float = 2.0) -> float:
    if not 0.0 < p <= 1.0:
        raise ValueError("p must lie in (0, 1].")
    return -math.log(p, base)

p_a = 0.4
p_b = 0.1

joint = surprisal(p_a * p_b)
separate = surprisal(p_a) + surprisal(p_b)

print(surprisal(0.5))   # 1.0 bit
print(surprisal(0.01))  # about 6.64 bits
print(joint, separate)  # equal up to floating-point error

assert math.isclose(joint, separate, rel_tol=1e-12)
Здесь joint измеряет информацию совместного наступления двух независимых событий с вероятностями и . Важно не подменять это утверждение независимыми маргиналами, когда события зависимы. Для зависимых событий разложение должно использовать условную вероятность:
Именно эта идея позднее станет основой условной энтропии и цепного правила.
Итог
Собственная информация события с вероятностью определяется не эстетическим выбором формулы, а структурой требований:
- она зависит от вероятности события;
- редкие события должны приносить больше информации;
- информация независимых наблюдений должна складываться;
- монотонность исключает патологические решения функционального уравнения.
Поэтому неизбежно получается семейство логарифмических мер:
Основание задаёт единицу: чаще всего биты при и наты при . Для ML это тот же объект, который на одном наблюдении выглядит как negative log-likelihood, а для последовательностей превращает произведение вероятностей в сумму token-level вкладов.
В следующем уроке мы усредним self-information по всем возможным исходам распределения и получим энтропию Шеннона — среднюю неопределённость в битах или натах.
Can't find a good explanation? Sign up and we'll make it for you
Sign up